Как создать свою нейросеть: три реальных способа
Как создать свою нейросеть: три реальных способа
«Создать свою нейросеть» - это на самом деле три разные задачи с разной ценой входа. Можно обучить модель с нуля, можно взять готовую с открытыми весами и дообучить её на своих данных, а можно настроить поведение чужой модели промптом и контекстом, ничего не обучая.
Для большинства практических задач нужен третий путь, реже второй и почти никогда первый. Ниже - что требует каждый способ по данным, железу и времени, и как проверить, не решается ли ваша задача готовой моделью ещё до того, как вы начнёте что-то обучать.
Что значит «создать свою нейросеть»
Первый вариант - обучение с нуля: архитектура и веса создаются заново, на своих данных. Второй - дообучение (fine-tuning): берётся готовая модель с открытыми весами, её параметры донастраиваются на новом датасете. Третий - настройка поведения готовой модели через системный промпт, контекст и ограничения, без изменения весов.
Разница между ними не в терминах, а в ресурсах: коде, данных, железе и времени.
Способ 1: обучить нейросеть с нуля
Самый затратный путь. Вы собираете архитектуру, готовите датасет и обучаете веса на вычислительных мощностях - обычно на кластерах GPU.
Что нужно:
- большой датасет, размеченный под задачу: требуемый объём зависит от архитектуры и сложности задачи
- вычислительные мощности - от одной видеокарты для маленькой модели до кластера для крупной
- знание фреймворков для обучения (PyTorch, TensorFlow или аналоги) и архитектур нейросетей
- время - от недель до нескольких месяцев на итерации, обучение и валидацию
Когда это оправдано
- задача настолько специфичная, что готовых моделей под неё нет
- у вас есть большой уникальный датасет, которого нет ни у кого другого
- есть команда с ML-экспертизой и бюджет на вычисления
Для задач вроде «написать текст», «сделать картинку», «ответить на вопрос по документу» этот путь избыточен: модель уже существует, и её проще настроить, чем создавать заново.
Способ 2: дообучить готовую модель (fine-tuning)
Компромисс между «с нуля» и «просто попросить модель». Берётся открытая модель с доступными весами, готовится датасет примеров под конкретную задачу, и веса меняются в процессе обучения на этом датасете.
Что нужно перед началом
- модель с открытой архитектурой и доступными весами - у закрытых моделей дообучение возможно только теми инструментами, которые предоставляет сам вендор, и на его условиях
- датасет примеров, размеченных под задачу: стиль, тон, формат ответа
- GPU с достаточным объёмом видеопамяти, требования растут с размером модели
- время на несколько итераций обучения и проверку результата на тестовых примерах
Дообучение оправдано, когда нужен специфичный стиль или узкий домен на базе существующей модели: например, чтобы модель писала строго в стиле конкретного бренда или отвечала только по внутренней документации компании. Дешевле и быстрее, чем обучение с нуля, но всё равно требует железа, датасета и понимания процесса - без кода тут не обойтись.
Способ 3: собрать помощника на основе готовых моделей
Здесь обучения нет. Веса модели не меняются - вместо этого задаётся системный промпт, контекст и ограничения по теме, а работа идёт прямо в интерфейсе.
Разница с дообучением принципиальная: дообучение меняет модель, промпт формулирует для неё задачу. Никакого доступа к весам и никакого железа для обучения не требуется.
Собрать такого помощника можно без единой строчки кода. Поведение задаётся четырьмя блоками, которые пишутся в начале запроса:
Роль: кто отвечает и с какой экспертизой.
Задача: что нужно сделать с входными данными.
Формат: структура ответа - разделы, длина, порядок.
Ограничения: чего делать нельзя и что делать при недостатке данных.Пример под тему статьи - помощник, который консультирует по выбору между обучением и промптингом:
Роль: инженер по машинному обучению, объясняешь без academic-жаргона.
Задача: по описанию задачи пользователя определить, что ему нужно -
обучение с нуля, дообучение открытой модели или настройка готовой
модели промптом.
Формат:
1) вывод одной строкой - какой из трёх путей подходит;
2) почему именно он, 2-3 пункта;
3) что понадобится: данные, железо, время;
4) чем проверить решение до вложений.
Ограничения: не предлагать обучение, если задача закрывается готовой
моделью. Не называть конкретных цифр по стоимости и срокам.
Если в описании не хватает данных об объёме датасета - сначала задать
один уточняющий вопрос.Порядок сборки: сначала опишите роль и задачу, потом добавьте формат, потом ограничения, потом прогоните черновик на 5-10 типовых запросах и допишите ограничения там, где ответ ушёл не туда.
Критерии, по которым видно, что настройка работает:
- формат соблюдён во всех прогонах, а не только в первом
- при нехватке данных модель задаёт вопрос, а не додумывает
- модель остаётся в заданной теме и не выходит за ограничения
- на один и тот же запрос ответы совпадают по структуре и по сути
Проверить логику можно на простом запросе: попросить модель объяснить разницу между обучением с нуля, дообучением и промптингом с примером задачи для каждого случая.
Сравнение трёх подходов
| Критерий | С нуля | Дообучение | Готовая модель + настройка |
|---|---|---|---|
| Нужен код | глубокие знания ML | средний уровень | не обязателен |
| Данные | датасет с нуля, много | датасет под задачу | не нужен |
| Железо | кластер GPU | GPU с большим объёмом памяти | браузер |
| Время | недели-месяцы | дни-недели | минуты-часы |
| Стоимость | вычисления в дата-центре | требует своего или арендованного железа | подписка на доступ к моделям |
| Когда оправдано | узкая уникальная задача, большой массив данных | нужен специфичный стиль или домен на базе открытой модели | большинство практических задач |
Как проверить модели перед тем, как выбрать путь
Прежде чем вкладываться в обучение или дообучение, стоит проверить простое: не решает ли задачу готовая модель без доработки. Возьмите одну формулировку задачи и прогоните её по очереди через текстовые модели в каталоге, а результаты оцените по качеству и точности выполнения.
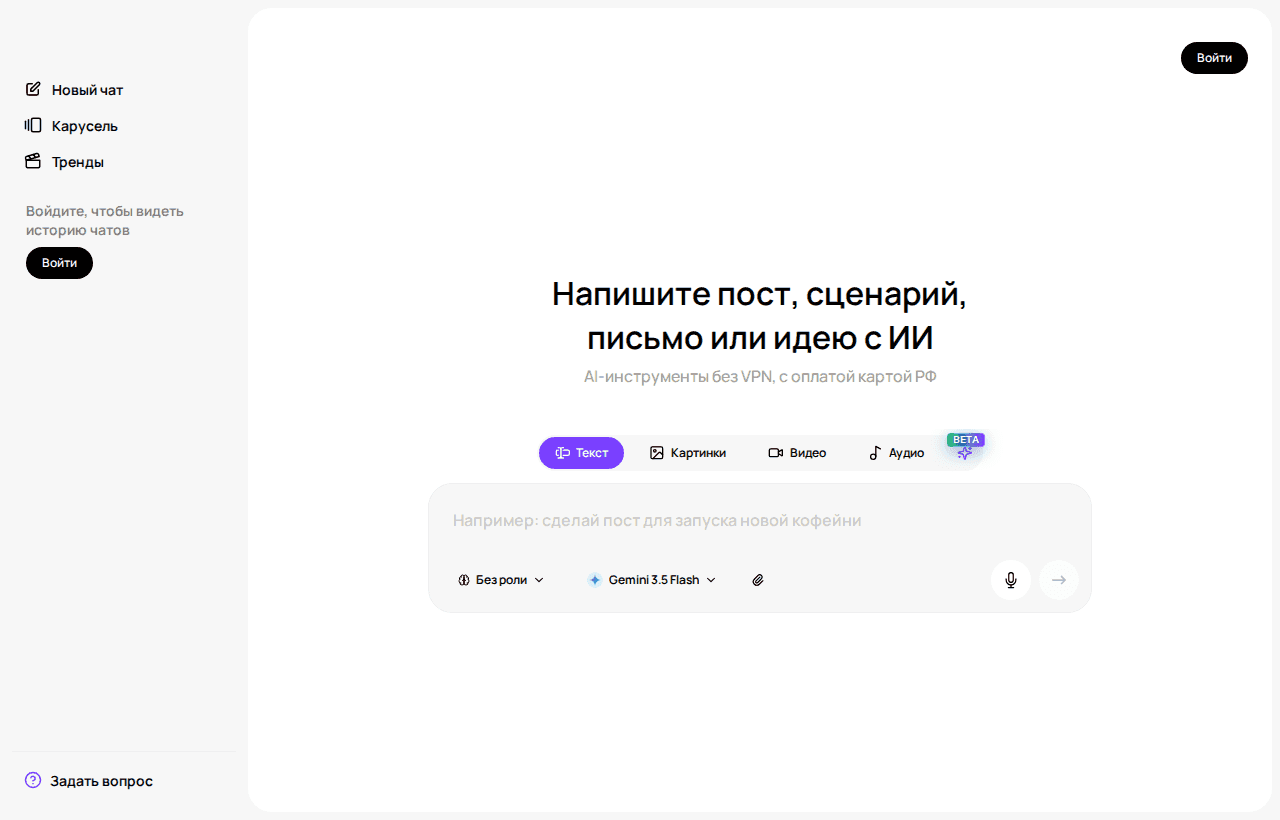
Если задача связана с изображениями, посмотрите, что дают готовые модели генерации по текстовому описанию - часто нужного результата хватает без обучения. С музыкой логика та же: трек можно собрать сразу на готовой модели. Для видео порядок тот же: сначала прогоните одно описание через видеомодели, а выводы делайте по результату. В Молекуле модели разных вендоров доступны под одной подпиской, поэтому перебрать их можно без регистрации в десятке отдельных сервисов; у каждой модели своя стоимость запуска в кредитах, она видна в каталоге и в интерфейсе.
Какие задачи не требуют своей модели
Большая часть повседневных задач закрывается готовой моделью и точной формулировкой запроса:
- написание и редактирование текстов в заданном стиле
- генерация изображений по текстовому описанию
- ответы на вопросы по загруженному документу через контекст
- перевод, суммаризация, транскрипция аудио
- генерация музыки и видео по референсу или описанию
Если задачу можно сформулировать словами и подкрепить примером - скорее всего, обучать свою модель не нужно.
Частые ошибки
- начинают с обучения с нуля там, где хватило бы точной формулировки промпта
- путают дообучение с промптингом и ждут от системного промпта результата, который даёт только изменение весов
- собирают датасет, не оценив, сколько примеров нужно для устойчивого результата
- рассчитывают дообучить закрытую модель своими силами, не проверив, даёт ли вендор такую возможность и на каких условиях
- тратят недели на подготовку к обучению, не проверив, решает ли задачу существующая модель
Ориентир простой: чем уже задача и чем больше у вас уникальных данных под неё, тем ближе вы к дообучению или обучению. Чем задача обычнее, тем быстрее её закрывает готовая модель с правильно поставленным вопросом. Разборы отдельных задач и запросов по моделям - в блоге Молекулы.
Материалы по теме
Частые вопросы
Похожие статьи
 Учёба
Нейросеть для учёбы: какую выбрать и как использовать
Разбираем, какие нейросети реально помогают студенту: конспекты, объяснение тем, поиск источников, работа с файлами и картинками.
 Текст и работа
Создать тест: как сделать свой тест онлайн и получить понятный результат
Когда текст слишком объёмный, читать и работать с ним становится сложно. Нужно сделать конспект, сократить рассказ, подготовить доклад или быстро выделить смысл — и тут важно убрать лишнее, но не потерять основную мысль. С этим помогает Молекула АИ: сервис умеет сократить текст онлайн, оставить ключевые идеи и преобразовать даже длинный фрагмент в компактный, понятный вариант.
 Текст и работа
Создать конспект: как упростить работу с материалами и не терять главное
Когда текст слишком объёмный, читать и работать с ним становится сложно. Нужно сделать конспект, сократить рассказ, подготовить доклад или быстро выделить смысл — и тут важно убрать лишнее, но не потерять основную мысль. С этим помогает Молекула АИ: сервис умеет сократить текст онлайн, оставить ключевые идеи и преобразовать даже длинный фрагмент в компактный, понятный вариант.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды