Лучшие нейросети для написания текстов: сравнение 2026
Лучшие нейросети для написания текстов: сравнение 2026
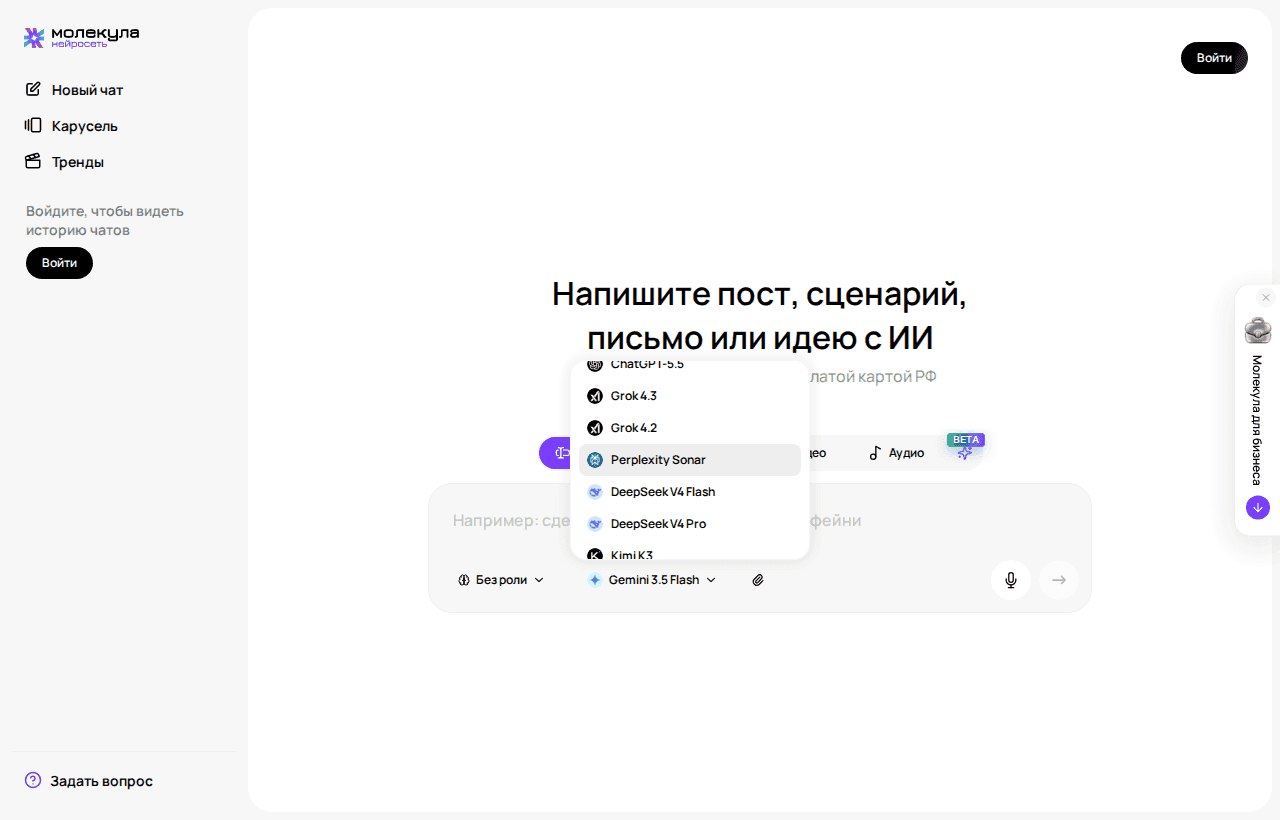
Короткий ответ на вопрос «какую модель взять под текст»: для длинной структурной статьи берите флагман (Claude Opus 5, GPT-5.6 Sol, Gemini 3.1 Pro), для потока коротких текстов - лёгкую модель (Claude Haiku 4.5, GLM 4.7, DeepSeek V4 Flash), а если в тексте нужны проверяемые факты и ссылки - модель с веб-поиском из линейки Perplexity Sonar. Разница между этими тремя группами больше, чем разница внутри группы. Дальше - чем модели отличаются, как выглядит рабочий запрос и где нейросети врут предсказуемо.
Что на самом деле отличает модели для текста друг от друга
Все крупные текстовые модели пишут связный русский. Разница проявляется в четырёх местах.
- Удержание структуры. Флагманы держат план на 8-10 тысяч знаков. Лёгкие модели плывут после третьего-четвёртого раздела.
- Плотность текста. Тяжёлые модели лучше держат ограничение по знакам и охотнее заменяют оценку («это очень удобно») на факт.
- Следование запретам. «Не пиши оценочных прилагательных» - проверка на послушание. Лёгкие модели забывают ограничение к середине ответа.
- Доступ к свежим данным. Обычная модель работает по памяти обучения, поиск по сети есть только у моделей, сделанных под это.
Отдельно стоит режим рассуждения: модели вроде Kimi K2 Thinking или Qwen3 Max Thinking сначала строят внутренний план, потом пишут. На простом посте это лишние затраты, на сложном аналитическом разделе разница заметна.
Короткий ответ: какую модель брать под какой тип текста
- Статья, лонгрид, документ на несколько страниц. Claude Opus 5, GPT-5.6 Sol, Gemini 3.1 Pro, Kimi K3.
- Рабочая середина: письма, КП, инструкции. Claude Sonnet 5, GPT-5.6 Terra, Gemini 3.5 Flash, GLM 5.2.
- Поток коротких текстов: посты, описания, заголовки. Claude Haiku 4.5, GLM 4.7, DeepSeek V4 Flash, GPT-5.6 Luna, Gemma 4.
- Текст с фактами, цифрами и ссылками. Perplexity Sonar, Sonar PRO, Sonar Deep Research.
- Разбор файла или картинки перед написанием. Gemini 3.1 Pro, ChatGPT-5.5, DeepSeek V4 Pro, Qwen 3.6 Plus.
Если не хочется держать это в голове, задачу можно описать словами модели МОЛЕКУЛА, и инструмент она подберёт сама. Общая картина по типам задач разобрана в обзоре нейросетей 2026 года.
Таблица: текстовые модели в Молекуле и стоимость запуска
Стоимость запуска указана в кредитах подписки на февраль 2026, актуальная цифра всегда видна рядом с моделью в интерфейсе.
| Модель | Кредитов за запуск | Под что берут |
|---|---|---|
| DeepSeek V4 Flash | 1 | черновики, короткие тексты, вложения |
| GPT-5.6 Luna | 1 | посты, подписи, быстрые правки |
| GLM 4.7 Flash | 1 | массовые описания, заголовки |
| МОЛЕКУЛА | 1 | задача словами, без выбора модели |
| GLM 4.7 | 2 | повседневные рабочие тексты |
| Perplexity Sonar | 2 | факты со ссылками |
| Kimi K2 Thinking | 3 | аналитика с длинной цепочкой |
| GLM 5.2 | 4 | сложные структурные тексты |
| Claude Haiku 4.5 | 5 | короткие тексты в потоке |
| GPT-5.6 Terra | 6 | рабочая середина |
| Perplexity Sonar Deep Research | 8 | глубокий ресёрч с цитатами |
| Claude Sonnet 5 | 10 | письма, документы, редактура |
| Gemini 3.1 Pro | 12 | лонгриды, работа с файлами |
| Perplexity Sonar PRO | 15 | поиск в реальном времени |
| Claude Opus 5 | 24 | сложные длинные тексты |
| GPT-5.6 Sol | 28 | универсальный флагман |
| Claude Fable 5 | 48 | художественный и сценарный текст |
Длинные тексты: статьи, лонгриды, разделы сайта
Главная ошибка - просить всё сразу. Запрос «напиши статью на 10 000 знаков» почти всегда даёт равномерную кашу: в каждом разделе одна мысль и три абзаца воды вокруг.
Работает другой порядок. Сначала просите только план: 6-8 разделов с одной строкой о содержании каждого. План правите руками, потом просите писать по два-три раздела за запрос, передавая утверждённый план в каждом сообщении. Структура остаётся вашей, модель не теряет контекст, правки локальные. Для художественного и сценарного текста логика та же, только вместо плана разделов идёт поэпизодник - об этом отдельно в материале про то, как написать сценарий с ИИ.
Признак, что модель не справляется с объёмом: к концу появляются абзацы «таким образом, выбор зависит от многих факторов». Значит, план потерян и модель заполняет место. Возьмите модель тяжелее или дробите на меньшие куски.
Короткие тексты: посты, письма, описания, заголовки
Здесь флагман не нужен и часто мешает: он расписывает то, что должно быть в трёх строках. Что критично:
- Жёсткий объём. Не «коротко», а «до 600 знаков», «заголовок до 60 символов».
- Количество вариантов. Просите сразу 5-7 версий и выбирайте, а не правьте одну.
- Пример своего стиля. Вставьте два своих старых поста: «пиши так же по ритму и лексике». Это даёт больше, чем описание тона словами.
Для писем добавляйте контекст переписки и цель: «нужно получить перенос срока на неделю, не признавая просрочку своей». Без цели модель пишет вежливое ни о чём. Если задача ближе к диалогу, подбор моделей другой, про это есть разбор моделей для диалога и общения.
Тексты с фактами и ссылками: когда нужен веб-поиск
Обычная текстовая модель ссылки придумывает: генерирует правдоподобный URL, потому что её задача - продолжить текст, а не проверить адрес. Реальный домен, осмысленный слаг, страницы нет.
Правило простое: любое проверяемое утверждение (цифра, дата, норма закона, чужое исследование) пишет модель с поиском. Perplexity Sonar - для одиночных фактов, Sonar PRO - для поиска по нескольким источникам в реальном времени, Sonar Deep Research - для обзора темы с цитированием. Порядок такой: сначала собираете факты моделью с поиском, открываете ссылки и читаете, потом отдаёте проверенные тезисы обычной модели на написание. В одном запросе смешивать ресёрч и написание плохо: часть фактов всё равно окажется из памяти модели.
Там, где цена ошибки высокая, модель даст структуру и формулировки, но нормы и требования проверяйте по первоисточнику - это касается и нейросетей для курсовой работы, и такой задачи, как подготовка искового заявления.
Как составить запрос, чтобы текст не пришлось переписывать
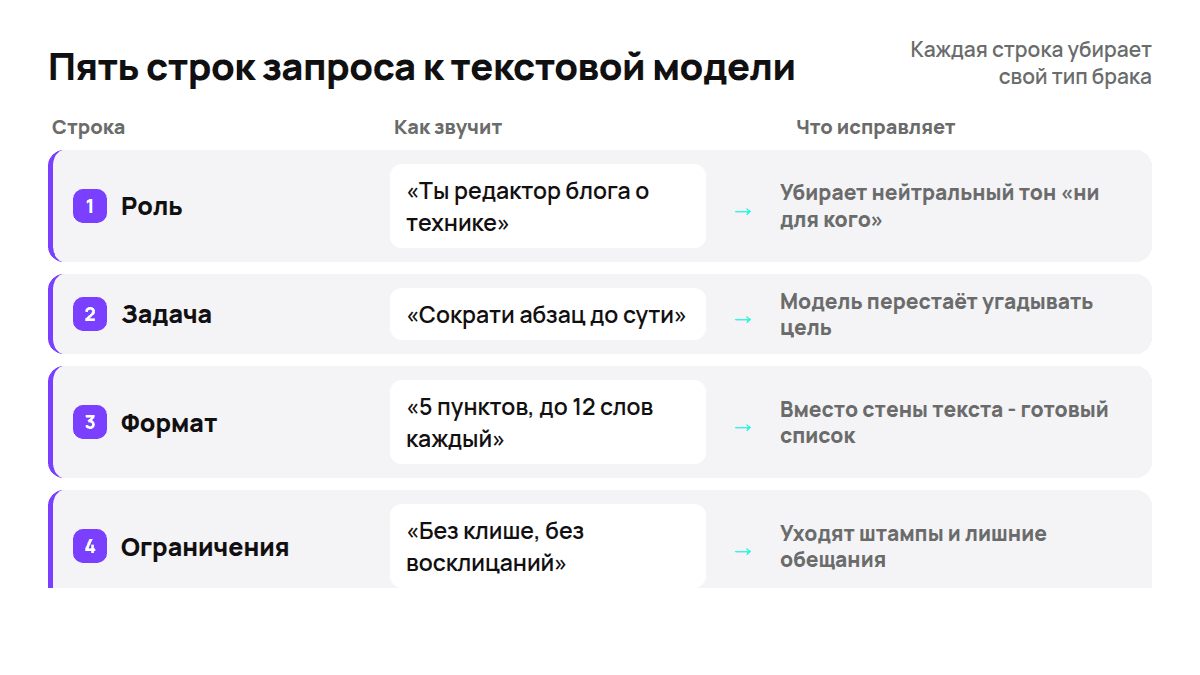
Рабочий запрос состоит из пяти строк, и каждая закрывает свой класс ошибок:
РОЛЬ: ты редактор корпоративного блога, пишешь для практиков.
ЗАДАЧА: статья про выбор CRM для компании из 10-30 человек.
Читатель - владелец бизнеса без ИТ-отдела, выбирает первую CRM.
ФОРМАТ: 4000 знаков, 6 разделов с подзаголовками, абзац 2-4 предложения,
в каждом разделе один конкретный критерий или пример.
ОГРАНИЧЕНИЯ: без вступлений про технологии и рынок; без оценочных
прилагательных (удобный, современный, мощный); не называй цены и
названия систем, которых я не дал; не выдумывай статистику.
ПОРЯДОК: сначала покажи план из 6 разделов и ждан моего «ок»,
потом пиши по два раздела за ответ.- Роль задаёт лексику: без неё модель пишет усреднённо-маркетинговым языком.
- Задача с аудиторией убирает половину воды.
- Формат в знаках и разделах - единственный способ получить предсказуемый объём.
- Ограничения пишите как запреты конкретных конструкций: «без воды» ничего не значит, «без оценочных прилагательных» - проверяемо.
- Порядок с паузой на «ок» не даёт модели уйти писать 4000 знаков по плохому плану.
Готовый запрос по этому каркасу можно открыть сразу с заполненным полем и подставить свою тему.
Порядок работы: от брифа до вычитки за пять шагов
- Бриф на пять строк по каркасу выше. Пятнадцать минут здесь экономят час правок.
- План отдельным запросом на лёгкой модели: планы дешёвые, их можно попросить два-три и собрать из них один.
- Факты, если они нужны, моделью с поиском. Ссылки открываете сами, цифры выписываете в отдельный список.
- Текст по частям на тяжёлой модели: два-три раздела за ответ, план и уже написанное в контексте.
- Вычитка вторым запросом: «сократи на 20 процентов, убери оценочные прилагательные, ничего не добавляй». Это работает лучше, чем просить сразу писать коротко.
Признак, что можно останавливаться: при следующем круге правок вы уже меняете формулировки на равнозначные, а не убираете лишнее.
Где модели стабильно ошибаются и что проверять руками
- Цифры и даты. Если цифру дали не вы - проверьте или удалите.
- Ссылки и источники. Открывайте каждую: несуществующие страницы попадаются даже у моделей с поиском.
- Цитаты и авторство. Модель легко приписывает известную фразу не тому человеку.
- Терминология вашей отрасли. Часто подставляется синоним, который в вашей сфере значит другое.
- Логика перечислений. Пункты, которые пересекаются или делят одно по разным основаниям.
- Штампы. «Играет важную роль», «нельзя не отметить». Ищите поиском по документу.
- Юридические и медицинские формулировки. Правильные по форме, неточные по сути.
Одна и та же модель на один запрос даёт разные ответы. Поэтому удачную формулировку запроса стоит сохранять в заметках, а не надеяться повторить результат по памяти.
Сколько кредитов уходит на текст и как не сжигать квоту
Внутри подписки расходуются кредиты, у каждой модели своя стоимость запуска. Разница между лёгкой и тяжёлой моделью - в десятки раз, и именно это определяет, на сколько текстов хватит квоты.
- Черновой и служебный труд - на моделях за 1-2 кредита: планы, варианты заголовков, сокращения.
- Финальное написание - на тяжёлой модели, но только когда план утверждён.
- Не переспрашивать одно и то же. Лучше собрать правки в один список.
- Не грузить лишние файлы. Вложения обрабатывают не все модели, и разбор большого файла ради одной цитаты редко оправдан.
Начать можно на бесплатном тарифе: там квота 5 кредитов, а один запрос текстовой модели доступен даже без регистрации. Для постоянной работы этого мало, но чтобы прогнать свой бриф через пару моделей и понять, чей стиль ближе, хватает.
Частые вопросы
Похожие статьи
 Текст и работа
Лучшие нейросети для написания курсовой работы в 2026 году: обзор, сравнение и как пользоваться
Нейросети уже вошли в учебный процесс. Сегодня студент может быстрее собрать материал по теме, составить план, сделать черновик, переработать текст, проверить проблемные фрагменты и подготовить оформление под требования кафедры. Это не отменяет самостоятельную работу, но заметно ускоряет подготовку и снимает часть рутинной нагрузки.
 Текст и работа
Лучшие нейросети для программирования в 2026 году: ТОП AI для написания кода, генерации и разработки
Раньше программист тратил часы на поиск решения, изучение документации и написание шаблонного code. Теперь нейросеть может сгенерировать фрагмент, предложить вариант реализации и объяснить, как работает алгоритм. Это меняет сам подход к работе.
 Текст и работа
Лучшие нейросети 2026: ТОП AI-сервисов для текста, изображений, видео, кода и бизнеса
Нейросеть перестала быть экспериментом. Это рабочий инструмент, который ускоряет задачи и даёт результат сразу. Бизнес автоматизирует процессы, маркетинг получает контент за минуты, разработка работает быстрее. Сегодня нейросеть создаёт текст, генерирует изображение, делает видео, пишет код и анализирует данные. Один сервис закрывает несколько задач и экономит время.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды