Как очеловечить текст, написанный ИИ: приёмы и проверка
Почему текст нейросети опознаётся с первых двух абзацев
Машинный текст выдаёт не лексика, а предсказуемость. Модель подбирает следующее слово по вероятности, поэтому получается речь без неожиданных поворотов: ровный ритм, симметричные абзацы, вводные обороты на месте, где живой автор просто начал бы с дела. Читатель не анализирует это осознанно, он чувствует, что текст ни к кому не обращается.
Второй признак - отсутствие цены суждения. В машинном абзаце нет ни одной фразы, за которую автор мог бы отвечать: нет цифр, которые можно проверить, нет случая из практики, нет «так делать не стоит, потому что». Значит правка идёт по двум направлениям: сначала снимаем шаблонность формы, потом дописываем то, чего у модели быть не могло. Переписать первый слой поможет и сама нейросеть для генерации текста, второй придётся делать руками.
Признаки машинного текста: до и после
Проще всего править по списку. Вот то, что встречается почти в каждой генерации.
- Вводные штампы. До: «Важно отметить, что выбор модели играет ключевую роль в процессе работы». После: «Модель выбирают под жанр текста, а не наоборот».
- Парные конструкции. До: «быстро и эффективно», «удобный и понятный интерфейс». После: одно прилагательное или ни одного. «Интерфейс понятный» чаще всего можно вообще вычеркнуть.
- Обобщения без содержания. До: «Это существенно повышает качество результата». После: «После правки абзац стал короче на треть, смысл не поменялся».
- Симметрия абзацев. Три абзаца по четыре предложения подряд читаются как таблица. Разбейте: один абзац в две строки, следующий в пять.
- Вывод, повторяющий введение. До: «Таким образом, мы рассмотрели основные приёмы». После: последняя мысль, которой в тексте ещё не было, или короткий совет.
- Списки-клоны. Все пункты одинаковой длины и одинаковой структуры «существительное плюс пояснение». Живой список неровный.
- Универсальные связки. «Кроме того», «в свою очередь», «стоит также упомянуть». Заменяются на конкретную связь: «отсюда следует», «но есть исключение».
Как поставить задачу модели, чтобы переписывать пришлось меньше
Половина шаблонности приходит из запроса вида «напиши статью про X». Модель не знает, для кого текст, и отвечает усреднённо. Поэтому в первый же запрос стоит положить рамки, которые потом не придётся вычищать.
Что именно добавлять:
- Читателя и его ситуацию: «пишу для редактора, который уже работал с моделями и не хочет объяснений, что такое промт».
- Запрет на штампы списком: перечислите три-четыре оборота, которых не хотите видеть. Абстрактное «пиши живо» модель игнорирует, конкретный стоп-лист работает.
- Ритм: «фразы разной длины, минимум два предложения короче семи слов на абзац».
- Ограничение по объёму в знаках. Без него модель раздувает текст водой, и вы будете резать то, что сами заказали.
- Требование не выдумывать факты: «если данных нет, оставь пометку [нужна цифра]».
Последний пункт экономит больше всего времени. Модель честно расставит заглушки, и вы сразу увидите, где текст держится ни на чём.
Восемь приёмов правки
Порядок важен: сначала крупное, потом мелкое. Если начать с лексики, а потом переставлять абзацы, работу придётся делать дважды.
- Уберите первый абзац. В девяти случаях из десяти это разогрев. Текст начинается со второго.
- Проверьте порядок абзацев. Машинный текст идёт по плану, а не по логике читателя. Перенесите вперёд то, за чем человек пришёл.
- Сломайте симметрию. Соедините два коротких абзаца, длинный разбейте на два.
- Вычистите вводные. «Важно отметить», «следует учитывать», «как известно» удаляются без потери смысла. Если после удаления фраза рассыпалась, значит в ней и не было смысла.
- Разберите парные прилагательные. Оставляйте одно, самое точное.
- Замените обобщение на факт. «Существенно дешевле» становится «дешевле в пять раз» или исчезает.
- Перепишите связки. Каждое «кроме того» - место, где автор не понял, как связаны мысли. Сформулируйте связь.
- Прочитайте вслух. Место, где вы сбились или сделали вдох посреди фразы, и есть место для точки.
После восьмого шага текст обычно теряет 15-25% объёма. Это нормально: уходит служебная речь.
Рабочий промт для переписывания
Это каркас, который можно скопировать целиком и менять четыре строки. Проверяйте его сначала на одном абзаце, а не на всей статье: так видно стиль модели и не тратится квота.
Роль: редактор, который правит машинный текст под живую речь.
Задача: перепиши текст ниже, сохранив структуру и все факты.
Что сделать:
- удали вводные обороты: «важно отметить», «стоит учитывать»,
«в целом», «как известно», «таким образом»
- разбей парные конструкции, оставь одно прилагательное
- чередуй длину фраз: минимум два предложения короче
семи слов на каждый абзац
- замени связки «кроме того», «в свою очередь» на связь по смыслу
- абзацы разной длины: от двух до пяти предложений
Чего не делать:
- не менять цифры, названия, термины и порядок шагов
- не добавлять факты, которых нет в исходнике
- не дописывать вывод и не пересказывать начало в конце
Формат ответа: только переписанный текст, без комментариев.
Объём: не больше исходного.
Текст:
<вставить абзац>Что менять под себя: строку роли (например, «редактор технической документации» даст суше, «автор рассылки» разговорнее), стоп-лист оборотов под свои штампы, требование по ритму и запрет на добавление фактов. Последний пункт не снимайте: без него модель дописывает правдоподобные, но выдуманные детали.
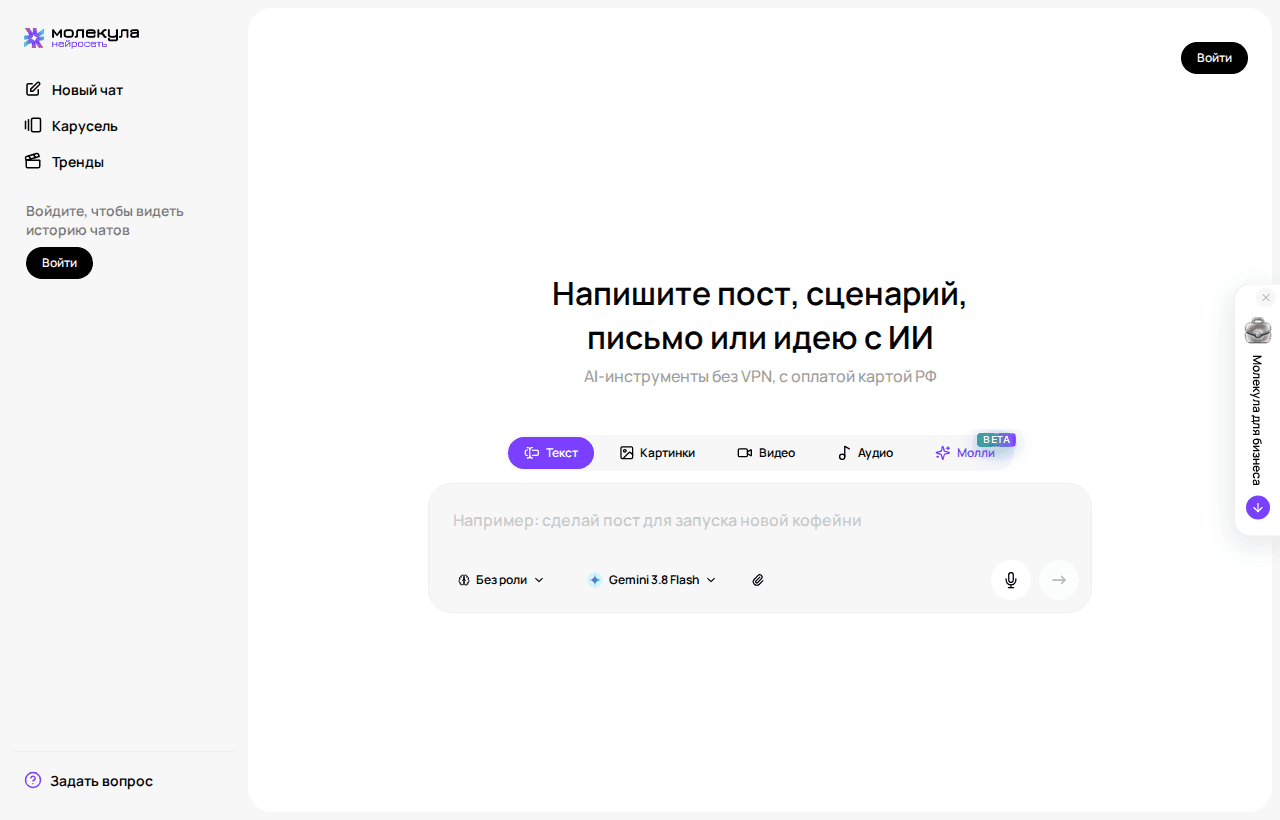
Готовый запрос с этим текстом уже можно отправить текстовой модели - останется вставить свой абзац.
Что добавляет только автор
Промт снимает форму, но не наполняет текст. Дальше идут четыре вещи, которых у модели нет по определению.
- Факты и цифры. Не «это недорого», а конкретная стоимость запуска. Модель такие числа выдумывает уверенно и неправильно, поэтому берите их из своих источников.
- Личный случай. Одна фраза «я прогнал три абзаца и на втором модель переписала терминологию» делает текст авторским надёжнее, чем любая стилистическая правка.
- Возражение. Где подход не работает. В машинном тексте почти никогда нет слова «не»: всё хорошо и всё полезно.
- Оценка риска. Сколько стоит ошибка, что придётся переделывать. Это то, что читатель не найдёт в компиляции.
Практический приём: пройдите по тексту и отметьте абзацы без единого проверяемого утверждения. Либо добавьте туда факт, либо удаляйте абзац. Если удалять нечего жалко, значит текст был пустой.
Как перечитать и найти остатки шаблонности
Проверка занимает минут десять и делается в четыре прохода.
- Поиск по стоп-словам. Прогоните текст поиском по своему списку: «важно», «также», «в целом», «эффективн», «ключев», «позволяет». Каждое найденное решайте отдельно.
- Замер абзацев. Посчитайте предложения в каждом абзаце. Если подряд идут три одинаковых числа, ритм машинный.
- Первые слова. Выпишите первое слово каждого абзаца в столбик. Повторы и служебные связки сразу видны.
- Чтение вслух с конца. Последние два абзаца перечитайте первыми: именно там чаще всего сидит пересказ введения.
Признак, что получилось: вы можете назвать три конкретных утверждения из текста, за которые готовы отвечать. Если нет, правка была косметической.
Детекторы ИИ: что они на самом деле измеряют
Детекторы оценивают статистику текста: насколько предсказуемо следующее слово и насколько ровно это распределено по тексту. Чем ровнее и предсказуемее, тем выше оценка «машинности». Это не определение авторства, а оценка стиля.
Отсюда обе ошибки. Сухой человеческий текст по шаблону (юридический, инструкция, отчёт) детектор часто помечает как машинный, с тем же сталкиваются те, кто прогоняет диплом на ИИ и антиплагиат. Отредактированный машинный текст с неровным ритмом и конкретикой проходит как живой. Особенно шумят такие проверки на неанглийских текстах и на коротких фрагментах.
Как с этим жить: считайте оценку ИИ детектора текста подсказкой, где текст однообразен, и перечитывайте именно эти абзацы. Не переписывайте текст ради цифры в детекторе - так ломается смысл, а результат всё равно нестабилен между сервисами.
Какие текстовые модели брать под переписывание
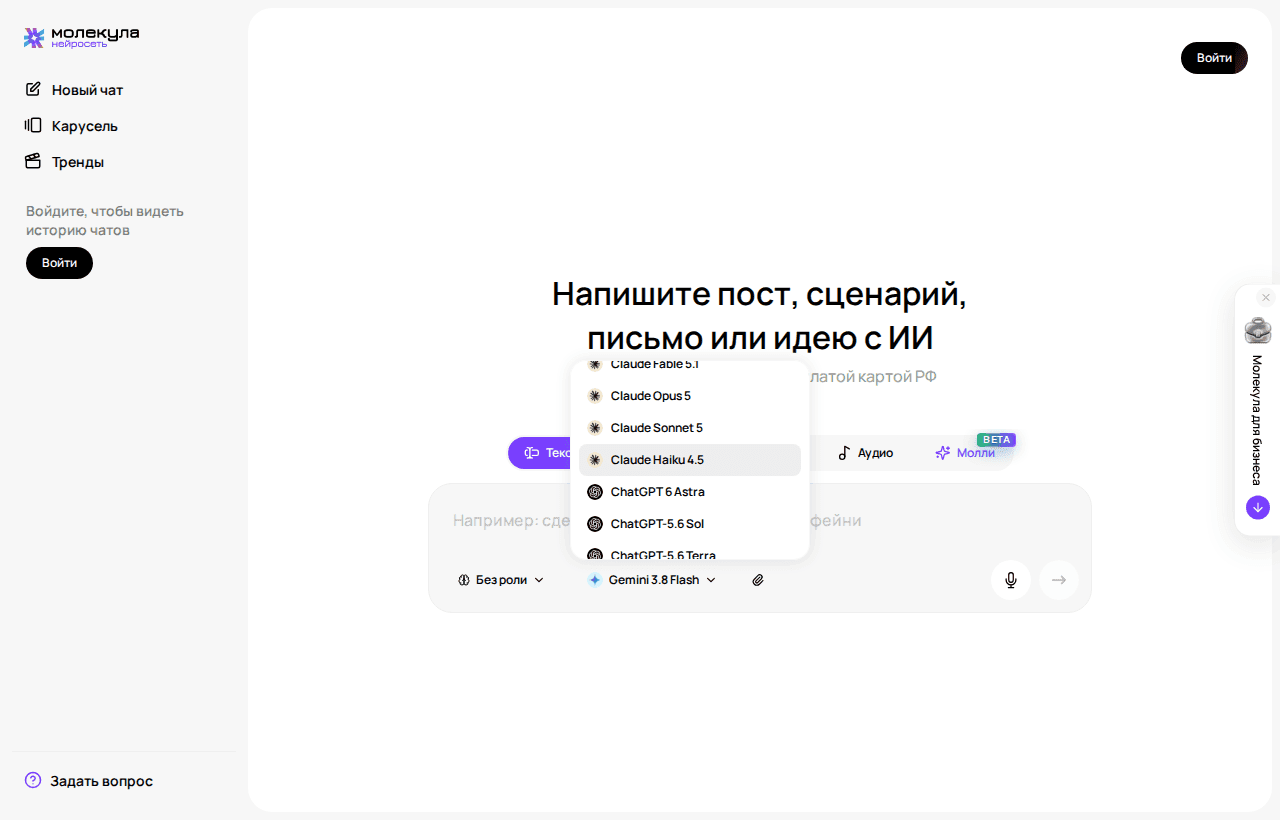
Универсального выбора нет: стиль зависит от жанра и языка. Рабочий подход - взять один абзац и прогнать через две-три модели разного класса, потом сравнить по трём критериям: сохранила ли цифры и термины, не раздула ли объём, не добавила ли выдуманных деталей.
Цены в кредитах ниже - на момент публикации, актуальная стоимость запуска видна рядом с моделью в интерфейсе.
| Модель | Кредитов за запуск | Для чего в этой задаче |
|---|---|---|
| Gemini 3.8 Flash | 1 | черновой прогон абзаца, когда нужно быстро |
| ChatGPT-5.6 Luna | 1 | дешёвая проверка, годится ли промт |
| DeepSeek V4 Pro | 2 | переписывание с разбором логики текста |
| Claude Haiku 4.5 | 5 | аккуратная правка стиля без раздувания |
| Claude Sonnet 5 | 10 | длинные фрагменты, где важно держать структуру |
| Claude Fable 5.1 | 48 | когда нужен выраженный авторский стиль |
Стоимость ошибки здесь низкая: неудачный прогон абзаца обходится в 1-5 кредитов, то есть сравнить три модели дешевле, чем один запуск видеомодели. На бесплатном тарифе квота 5 кредитов, этого хватит на один-два теста промта, дальше нужна подписка. Доступ к текстовым моделям в одном интерфейсе удобен ровно этим: прогнать абзац через разные модели можно, не заводя отдельные аккаунты, хотя сравнить ответы в одном окне Молекула не даёт - придётся отправлять запросы по очереди.
Если к статье нужны картинки, их делают отдельно: иллюстрации можно собрать нейросетью для фото, цена запуска у картиночных моделей выше текстовых.
Частые ошибки
- Переписывать целиком. Абзацы с цифрами, кодом и терминами модель правит охотно и неаккуратно. Оставляйте их как есть.
- Гонять больше двух итераций. Первая правка снимает штампы, вторая добавляет конкретику. На третьей текст начинает терять смысл и обрастать чужими фактами.
- Заказывать «разговорный стиль» без рамок. Получите сленг и панибратство там, где нужна инструкция.
- Путать живость с многословием. Метафоры и восклицания не делают текст авторским, а конкретная цифра делает.
- Верить детектору как приёмке. Смотрите на смысл, а не на процент.
- Забывать сверить факты после правки. Проверьте цифры и названия в переписанном абзаце против исходника: это самая частая потеря.
Итог простой: форму чинит промт за один-два прогона, содержание дописывает автор. Текст перестаёт звучать машинно не тогда, когда в нём нет штампов, а когда в нём есть то, чего модель не знала.
Частые вопросы
Похожие статьи
 Разбор ИИ
Как понять, что текст написан ИИ: признаки и проверка
Разбираем, по каким признакам текст выдаёт нейросеть, где ошибаются детекторы и как проверять материал вручную, не полагаясь на проценты «искусственности».
 Учёба
Как озвучить текст на английском онлайн с помощью Молекула АИ
Правильная английская озвучка текста важна в учебе, работе, контенте и повседневных задачах. Озвучить текст на английском онлайн удобно, когда нужно отрепетировать произношение, подготовить аудио для ролика, озвучить презентацию, воспроизвести диалог или просто прочитать английский текст онлайн с естественным голосом.
 Гайды по моделям
Онлайн проверка кода: как «Молекула» помогает находить ошибки и улучшать код
Когда текст слишком объёмный, читать и работать с ним становится сложно. Нужно сделать конспект, сократить рассказ, подготовить доклад или быстро выделить смысл — и тут важно убрать лишнее, но не потерять основную мысль. С этим помогает Молекула АИ: сервис умеет сократить текст онлайн, оставить ключевые идеи и преобразовать даже длинный фрагмент в компактный, понятный вариант.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды