Как делать ИИ-видео: пошаговый разбор генерации в нейросети
Чтобы получить короткий ролик нейросетью, нужны три вещи: сцена, описанная одним абзацем, выбор режима (из текста или из картинки) и понимание, что одна генерация даёт фрагмент на несколько секунд, а не готовый клип. Остальное - детали промта и терпение к повторным попыткам.
Ниже разбор по шагам: что нажимать, что писать в поле запроса, как оживить своё фото, чем отличаются видеомодели и почему результат расходится с картинкой в голове. Порядок - от простого к сложному: сначала одиночная генерация, потом камера, звук, апскейл и сборка длинного ролика.
Что понадобится до первой генерации
Минимальный набор: аккаунт в Молекуле с доступом к видеомоделям, запас кредитов и одна сформулированная сцена. Видеогенерация ощутимо дороже текста и картинок, поэтому пробовать «а что получится» вслепую невыгодно.
Перед тем как открывать поле промта, ответьте себе на четыре вопроса:
- Что происходит в кадре? Одно действие, а не три.
- Откуда смотрит камера и двигается ли она?
- Какой свет и время суток?
- Нужен ли исходный кадр или сцену придумывает модель?
Если ответ на первый вопрос звучит как «герой заходит в комнату, садится, открывает ноутбук и начинает говорить», ролик почти наверняка развалится. Пять секунд держат одно действие: пар поднимается, камера наезжает, человек поворачивает голову. Остальное разбивается на отдельные фрагменты.
Заранее решите и то, где вы соберёте результат: видеоредактор нужен даже для простого ролика - склеить два фрагмента, подложить музыку, обрезать лишние полсекунды.
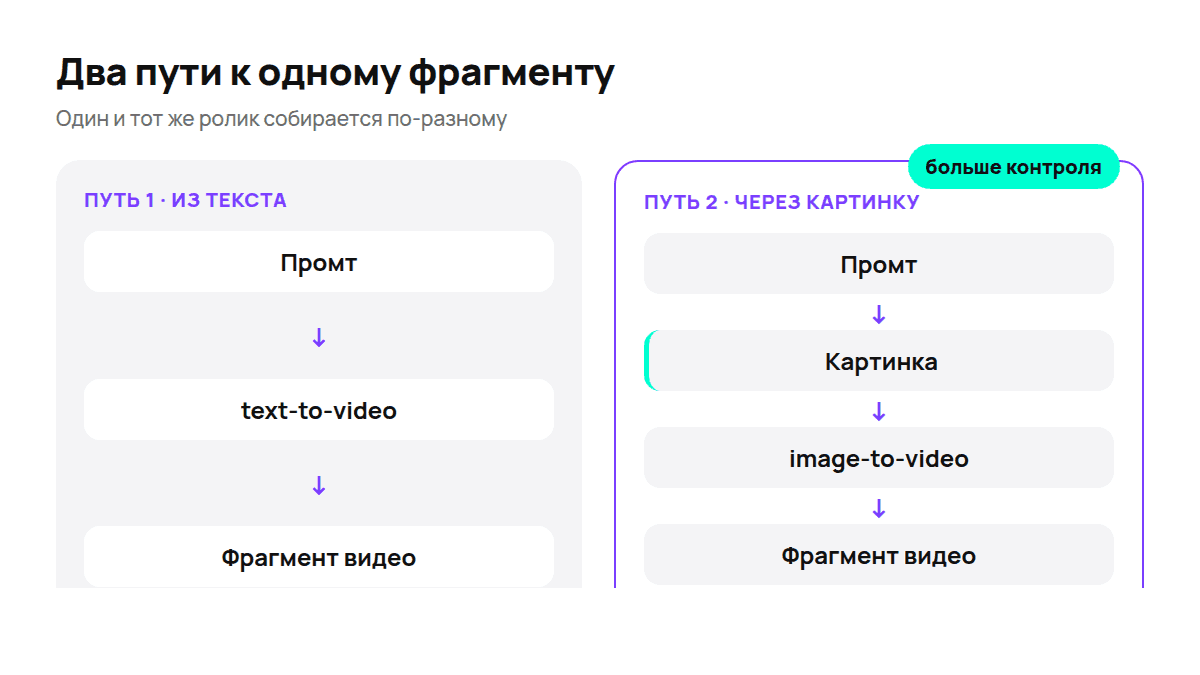
Два режима: видео из текста и видео из картинки
Text-to-video: вы описываете сцену словами, модель придумывает и композицию, и движение. Быстро, но непредсказуемо: лица, пропорции предметов и логика пространства уезжают чаще всего здесь.
Image-to-video: готовый кадр становится первым кадром ролика, а модель отвечает только за движение. Контроля больше, брака меньше. Цена такого контроля - нужен исходник.
Рабочая схема для большинства задач: сначала довести кадр картиночной моделью до состояния «вот это мне нравится», потом отправить его в image-to-video с описанием движения. Разница в проценте удачных генераций заметна сразу.
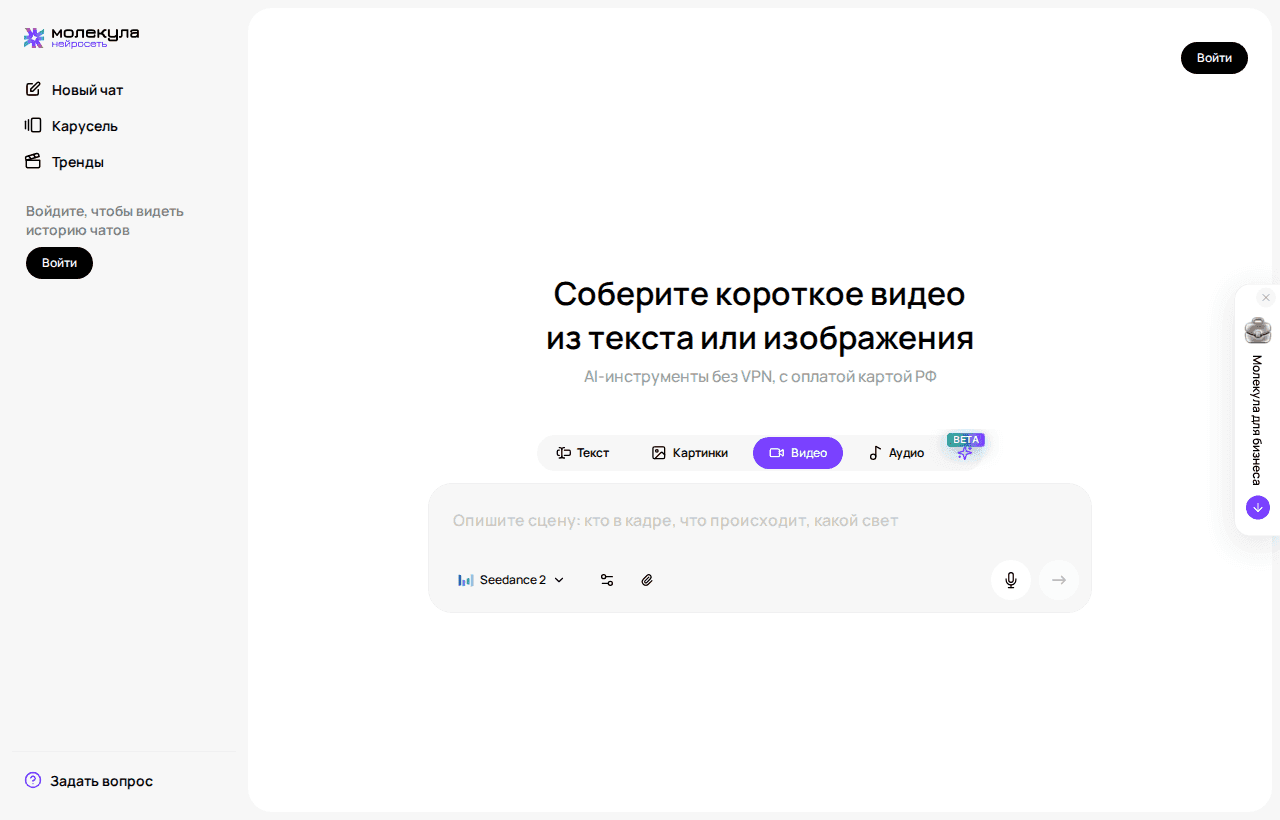
Как сгенерировать видео из текста: 6 шагов
- Найдите в каталоге видеомодель. Рядом с каждой видна стоимость запуска в кредитах - это первый фильтр выбора.
- Выберите модель под задачу: дешёвую для проверки идеи, более тяжёлую для финального дубля.
- Задайте параметры, которые модель разрешает менять: длительность, разрешение, соотношение сторон. Пропорции ставятся здесь, а не словами в промте.
- Напишите промт по структуре из раздела про промты: сцена, субъект, действие, камера, свет, стиль, ограничения.
- Запустите генерацию. Видео считается дольше картинки, это нормально.
- Посмотрите ролик дважды: целиком и на паузах в начале и конце. Именно на крайних кадрах вылезают лишние пальцы, деформация предметов и рывок камеры.
Дальше решение простое: ошибка в сюжете или композиции - правьте промт и перегенерируйте, ошибка в резкости - идите в апскейл.
Как оживить фото: image-to-video по шагам
- Подготовьте кадр, лучше в том же соотношении сторон, что и будущее видео, иначе модель обрежет края.
- Если исходника нет, можно сделать первый кадр картиночной моделью и уже потом анимировать.
- Выберите модель в режиме image-to-video и загрузите картинку.
- В промте описывайте только движение: модель уже видит, что на фото.
- Ограничьте лишнее: «камера не меняет ракурс», «фон остаётся неподвижным», «без новых объектов в кадре».
- Проверьте первый кадр результата: он должен совпадать с исходником. Если модель его переписала, снизьте амплитуду движения в описании.
Пример промта для оживления портретного фото:
Оживи кадр: человек медленно поворачивает голову к камере,
лёгкое движение волос от ветра, глаза мигают один раз.
Камера статична. Фон не меняется. Без новых объектов.
Длительность 5 секунд.Типичная ошибка - просить слишком много движения. «Персонаж встаёт и идёт» на пяти секундах из статичного фото почти всегда даёт плывущую анатомию.
Модели для видео и чем они отличаются
Выбор сводится к трём параметрам: поддерживаемый режим, заявленная длительность и разрешение. Ниже то, что модели заявляют о себе; состав каталога меняется, поэтому сверяйтесь с описанием рядом с моделью.
| Модель | Режимы | Что заявлено |
|---|---|---|
| Veo 3.1 | текст и картинка | опция 1080P |
| Veo Omni | текст и картинка | мультимодальный вход, до 4K |
| Kling 3.0 | текст и картинка | multi-shot, референсы элементов, режим 4K |
| Kling 2.1 Standard | картинка | 5 или 10 секунд |
| Seedance 2.0 | текст и картинка | мультимодальные референсы |
| Seedance 2.0 Mini | текст и картинка | быстрый и дешёвый вариант |
| Seedance v1 Lite | картинка | 480p/720p/1080p, 5 или 10 секунд |
| Hailuo 02 Standard | картинка | 512P/768P, 6 или 10 секунд |
| Wan 2.6 | картинка | 720p/1080p, 5, 10 или 15 секунд |
| HappyHorse | текст и картинка | до 1080P, до 15 секунд; для image-режима референс обязателен |
| Grok Imagine Video | текст | генерация видео по текстовому описанию |
| Grok Imagine (image-to-video) | картинка | оживление загруженного кадра |
Для черновиков берите модель подешевле и покороче, для финала - ту, где заявлено нужное разрешение. Нужна смена планов внутри одного фрагмента - смотрите на модели с заявленным multi-shot. Мы не разработчик этих моделей и не обещаем, что поведение в интерфейсе совпадёт с приложением вендора: обвязка и настройки могут отличаться.
Как писать промт для видео: структура и разбор примера
Промт для видео отличается от промта для картинки одним блоком: в нём есть время. Кроме того, что в кадре, нужно сказать, что меняется за эти секунды.
Рабочий каркас, который можно копировать и заполнять:
Длительность: 10 секунд
Сцена: [где происходит, время суток]
Субъект: [кто или что в кадре, крупность плана]
Действие: [одно изменение за весь фрагмент]
Камера: [статична / наезд / отъезд / проезд вбок, скорость]
Свет: [источник, направление, жёсткость]
Стиль: [реализм / плёнка / 3D-рендер, палитра]
Ограничения: [без текста, без новых объектов, без резких склеек]Заполненный пример:
Длительность: 10 секунд
Сцена: кухня у окна, раннее утро
Субъект: чашка кофе на деревянном столе, крупный план
Действие: от кофе поднимается пар, он медленно закручивается
Камера: медленный наезд, без рывков
Свет: утреннее солнце сбоку, мягкие тени
Стиль: реализм, тёплые цвета, малая глубина резкости
Ограничения: без текста и подписей, без рук в кадреЧто здесь работает и почему:
- одно действие (пар) вместо трёх;
- одно движение камеры вместо «наезд, потом облёт»;
- свет назван источником и направлением, а не словом «красиво»;
- ограничения написаны явно: подписи и водяные знаки модели любят добавлять сами.
Тот же промт в одну строку тоже сработает, если сохранить порядок блоков. Проверить можно на живом примере: готовый запрос про чашку кофе открывается сразу заполненным, останется выбрать видеомодель.
Движение камеры и смена планов: что реально управляемо
Надёжно отрабатывают простые операторские команды: статичная камера, медленный наезд, отъезд, проезд вбок, панорама влево или вправо, съёмка с рук с мелким дрожанием. Формулируйте их по одной и добавляйте скорость: «очень медленный наезд» и «быстрый наезд» дают разный результат.
Плохо управляются сложные связки вроде «облёт вокруг объекта на 180 градусов, потом переход на крупный план»: на коротком фрагменте модель либо выберет что-то одно, либо сломает геометрию сцены.
Смена планов внутри одной генерации - отдельная история. Часть моделей заявляет multi-shot, то есть несколько кадров в одном ролике. Если такой возможности нет, склейку делают руками: два фрагмента, монтажный стык в редакторе.
Полезная привычка: писать в ограничениях «без резких склеек и смены ракурса», если нужен один непрерывный план. Без этого модель иногда вставляет переход по своей инициативе.
Звук: эффекты, музыка и озвучка поверх ролика
Часть видеомоделей выдаёт видео без звука, часть со звуком, и по описанию это предугадать не всегда получается. Практичнее считать, что дорожку вы собираете сами.
Из чего её собирают:
- шумы и эффекты (шаги, дождь, гул города) - генерируются по текстовому описанию отдельной моделью для звуковых эффектов;
- музыкальный трек - модели семейства Suno, от коротких подложек до треков с вокалом;
- голос - записанный или подготовленный заранее файл, который вы подкладываете под видео.
Дальше всё сводится в видеоредакторе: дорожка видео, дорожка эффектов, дорожка музыки. Собственного монтажного стола в Молекуле нет.
Порядок такой: сначала финальный видеофрагмент, потом эффекты под конкретные действия в кадре, музыка последней. Иначе придётся подгонять видео под ритм трека, а перегенерация видео стоит дороже.
Апскейл и сборка ролика длиннее одной генерации
Мутный или мелкий результат чинится апскейлом: есть модель Topaz Video Upscale с увеличением до 4x. Она поднимает разрешение и детализацию, но не переделывает сюжет - лишние пальцы и дёрганую камеру апскейл только сделает заметнее.
Ролик длиннее одной генерации собирается фрагментами:
- Разбейте идею на фрагменты по 5-10 секунд, по одному действию на каждый.
- Сгенерируйте первый фрагмент.
- Возьмите его последний кадр как исходник для image-to-video следующего фрагмента.
- Держите одинаковые формулировки стиля, света и палитры во всех промтах.
- Склейте фрагменты в редакторе, при необходимости с короткими переходами.
Раскадровку удобно готовить текстом: можно попросить текстовую модель расписать промт по кадрам и получить список фрагментов с описанием действия и камеры. Дальше вы прогоняете этот список по видеомодели.
Стык между фрагментами всё равно будет заметен по мелочам: чуть другой оттенок, чуть другая текстура. Помогает единый цветокор на всём ролике в конце.
Почему видео получается «не то»: 7 частых ошибок
- Слишком много действий в одном фрагменте. Пять секунд держат одно изменение.
- Два движения камеры сразу. Наезд и облёт в одном промте дают кашу.
- Нет ограничений. Без «без текста и подписей» модель может дописать надпись в кадр.
- Промт описывает статичную картинку. Нет глаголов движения - получите почти неподвижный кадр.
- Пропорции заданы словами, а не параметром. «Вертикальное видео» в промте работает хуже настройки.
- Text-to-video там, где нужен конкретный объект. Товар, лицо или логотип надёжнее подавать картинкой.
- Правка всего промта сразу после неудачи. Меняйте один блок за раз.
Критерий «получилось»: первый и последний кадр нормальны на паузе, движение идёт в одну сторону без рывков, в кадре нет объектов, которых вы не просили.
Как считаются кредиты за видео
Внутри подписки списываются кредиты, и у каждой модели своя стоимость запуска - она видна в каталоге рядом с моделью. Видеогенерации дороже текстовых запросов, поэтому экономия достигается порядком работы, а не выбором тарифа.
Что реально снижает расход:
- проверять идею на быстрой и дешёвой модели, финал делать на тяжёлой;
- сначала доводить первый кадр картиночной моделью, где повтор стоит дешевле;
- генерировать короткую длительность на этапе подбора промта;
- не запускать дубли подряд без правки промта: одинаковый запрос даст похожий результат.
Квота кредитов обновляется каждый оплаченный период. На бесплатном тарифе выдаётся 5 кредитов - этого хватит познакомиться с текстовыми моделями, но не на видео. Апскейл и генерация звука тоже расходуют кредиты, их лучше планировать в конце, когда фрагмент утверждён.
Доступ работает из России без VPN, с русским интерфейсом и оплатой российской картой в рублях, так что зарубежная карта и иностранный номер не понадобятся.
Материалы по теме
Частые вопросы
Похожие статьи
 Текст и работа
Лучшие нейросети 2026: ТОП AI-сервисов для текста, изображений, видео, кода и бизнеса
Нейросеть перестала быть экспериментом. Это рабочий инструмент, который ускоряет задачи и даёт результат сразу. Бизнес автоматизирует процессы, маркетинг получает контент за минуты, разработка работает быстрее. Сегодня нейросеть создаёт текст, генерирует изображение, делает видео, пишет код и анализирует данные. Один сервис закрывает несколько задач и экономит время.
 Текст и работа
Лучшие нейросети для программирования в 2026 году: ТОП AI для написания кода, генерации и разработки
Раньше программист тратил часы на поиск решения, изучение документации и написание шаблонного code. Теперь нейросеть может сгенерировать фрагмент, предложить вариант реализации и объяснить, как работает алгоритм. Это меняет сам подход к работе.
 Текст и работа
Толкование сна онлайн: как разобрать сновидение с помощью нейросети
Когда текст слишком объёмный, читать и работать с ним становится сложно. Нужно сделать конспект, сократить рассказ, подготовить доклад или быстро выделить смысл — и тут важно убрать лишнее, но не потерять основную мысль. С этим помогает Молекула АИ: сервис умеет сократить текст онлайн, оставить ключевые идеи и преобразовать даже длинный фрагмент в компактный, понятный вариант.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды