Как создать искусственный интеллект: три пути и пошаговый план
Под «создать искусственный интеллект» обычно понимают одно из трёх: обучить свою модель с нуля, дообучить готовую открытую модель на своих данных или собрать помощника на основе существующей языковой модели. Первый путь объясняет, как всё устроено. Второй даёт модель под узкую задачу. Третий быстрее всего даёт рабочий инструмент.
Если нужен инструмент, а не учебный проект, начинайте с третьего пути: хватит нейросети для генерации текста и вечера на настройку запроса. Если хотите разобраться в машинном обучении, соберите маленькую нейросеть на Python. На это уйдёт несколько вечеров.
Что обычно имеют в виду под «создать ИИ» и чего ждать от первого проекта
Аналог ChatGPT в одиночку не сделать: большие языковые модели обучают компании на тысячах видеокарт и огромных массивах текста. Реальный первый проект скромнее:
- классификатор, который отличает спам от обычных писем;
- открытая модель, дообученная отвечать в стиле вашей поддержки;
- помощник, который по вашим правилам проверяет код.
Первый проект удался, если модель решает одну узкую задачу и вы можете в цифрах показать, насколько хорошо. «Умный бот обо всём» - пожелание, задачи в нём нет.
Три пути: модель с нуля, дообучение готовой, помощник на основе LLM
| Модель с нуля | Дообучение | Помощник на LLM | |
|---|---|---|---|
| Навыки | Python, основы ML | Python, работа с открытыми моделями | Сформулировать задачу и проверить ответ |
| Данные | Тысячи размеченных примеров | Сотни или тысячи пар «запрос - ответ» | 3-10 примеров в запросе |
| Железо | Обычный компьютер | Видеокарта с 16-24 ГБ памяти или облако | Браузер |
| Срок | Несколько вечеров | Недели | Один-два вечера |
| Результат | Модель под одну задачу и понимание основ | Модель с вашим стилем и терминами | Рабочий инструмент без обучения |
Что нужно знать до старта
- Python: функции, списки, словари, установка библиотек через pip, работа в Jupyter или Google Colab.
- Математика: вектор, матрица, производная как «насколько меняется результат», среднее и доля.
- Основы ML: обучающая и тестовая выборки, переобучение, метрики точность, полнота и F1.
Проверка готовности: если можете прочитать CSV-файл в pandas и посчитать строки каждого класса, начинайте. Для помощника на готовой модели ничего из этого не нужно.
Пошагово: первая нейросеть на Python от задачи до проверки качества
- Сформулируйте задачу: «на входе текст сообщения, на выходе спам или не спам».
- Возьмите открытый набор SMS Spam Collection: порядка 5,5 тысячи размеченных сообщений.
- Отложите 20% данных на проверку и не трогайте их до конца.
- Переведите тексты в числа, обучите модель, проверьте на отложенной части.
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.neural_network import MLPClassifier
from sklearn.metrics import classification_report
df = pd.read_csv(«spam.csv») # колонки: text, label
X_train, X_test, y_train, y_test = train_test_split(
df[«text»], df[«label»], test_size=0.2,
stratify=df[«label»], random_state=42)
vec = TfidfVectorizer(max_features=5000) # слова -> числа
model = MLPClassifier(hidden_layer_sizes=(64,), max_iter=50) # один скрытый слой
model.fit(vec.fit_transform(X_train), y_train)
print(classification_report(y_test, model.predict(vec.transform(X_test))))Смотрите на точность и полноту по классу «спам», а не на общую долю верных ответов. Спама в наборе порядка 13%, поэтому модель, которая всегда отвечает «не спам», наберёт около 87% и будет бесполезна. Для сравнения обучите логистическую регрессию: если нейросеть её не обгоняет, усложнять архитектуру незачем.
Данные: где взять, как разметить и почему от них зависит больше, чем от архитектуры
Где взять. Открытые наборы на Kaggle и Hugging Face, свои выгрузки писем, заявок, отзывов. Проверяйте лицензию и не берите персональные данные клиентов без согласия.
Как разметить. Напишите инструкцию на полстраницы с пограничными случаями. Разметьте 200 примеров сами, затем отдайте 50 из них второму человеку. Если расходитесь чаще чем в одном случае из десяти, правьте инструкцию, а не модель.
Почему данные важнее. Дубликаты, ошибки разметки и перекос классов портят результат сильнее, чем выбор между двумя архитектурами. Прежде чем менять модель, откройте 30 примеров, где она ошиблась: часть окажется размечена неверно.
Дообучение открытой модели: когда оно оправдано, а когда хватит хорошего промта
Дообучение оправдано, если модель не держит нужный формат даже с длинным запросом, запросов тысячи в день или данные нельзя отправлять во внешний сервис. Если задача описывается правилами и десятком примеров, хватит промта.
Полное дообучение меняет все веса и требует много памяти. Обычно используют LoRA: к замороженной модели добавляют небольшие адаптеры и обучают только их. Модель порядка 7-8 млрд параметров в режиме QLoRA дообучают на одной видеокарте с 16-24 ГБ памяти. Датасет - от нескольких сотен до нескольких тысяч пар «запрос - ответ» в одном формате. Библиотеки: transformers, peft, trl.
Ошибка стоит часов обучения, а ошибки в данных модель выучит вместе с остальным. Перед стартом прогоните 50 контрольных запросов через базовую модель с хорошим промтом. Дообученная модель должна обогнать этот результат, иначе работа была лишней.
Свой помощник на готовой языковой модели: роль, инструкции, примеры и проверка ответов
Помощник - это запрос из пяти частей: роль, задача, формат, ограничения, пример. Сохраните его в заметках и вставляйте в начало каждого диалога. Каркас помощника, который проверяет учебный код:
Роль: ты - ревьюер кода на Python для начинающих. Объясняешь простыми словами.
Задача: проверь мой код. Найди ошибки и места, где он упадёт на реальных данных.
Формат ответа:
1. Вердикт одной строкой: «работает», «упадёт» или «работает, но неверно».
2. Список проблем: строка, что не так, как исправить.
3. Исправленный фрагмент только для изменённых строк.
Ограничения: не переписывай код целиком. Не предлагай новые библиотеки, если хватает текущих. Если не уверен, так и напиши.
Пример:
Код: df = pd.read_csv(«spam.csv»); print(df[«Text»])
Ответ: Вердикт: упадёт. Колонка называется «text», а не «Text», будет KeyError. Исправление: df[«text»].Проверка ответов:
- Составьте 10 контрольных запросов, из них 3 с подвохом: код без ошибок, код на другом языке, просьба вне роли.
- В каждом ответе отметьте три признака: формат соблюдён, ошибка найдена, нет выдуманных функций.
- Версия инструкции годится, если 9 ответов из 10 проходят по всем трём признакам.
- Меняйте за раз одну строку инструкции, иначе не поймёте, что сработало.
Тот же набор прогоните на двух-трёх моделях разной цены. В Молекуле на октябрь 2026 запуск DeepSeek V4 Flash стоит 1 кредит, Claude Haiku 4.5 - 5, Claude Opus 5.5 - 20, актуальная цена видна рядом с моделью. Десять запросов на этих трёх моделях обойдутся в 260 кредитов. Если дешёвая модель проходит порог 9 из 10, дорогая не нужна.
Где подход не сработает: помощник не знает ваших внутренних документов, пока вы их не приложите, и не помнит прошлые диалоги. На длинных документах он может пропускать детали, поэтому выборочно сверяйте ответы с источником.
Как готовые нейросети помогают в самом процессе: объяснить код, найти ошибку, составить план обучения
- Объяснить код: вставьте фрагмент и попросите разобрать каждую строку.
- Найти ошибку: присылайте код и полный текст ошибки, а не «не работает».
- Составить план обучения онлайн: напишите, что уже знаете и сколько часов в неделю есть.
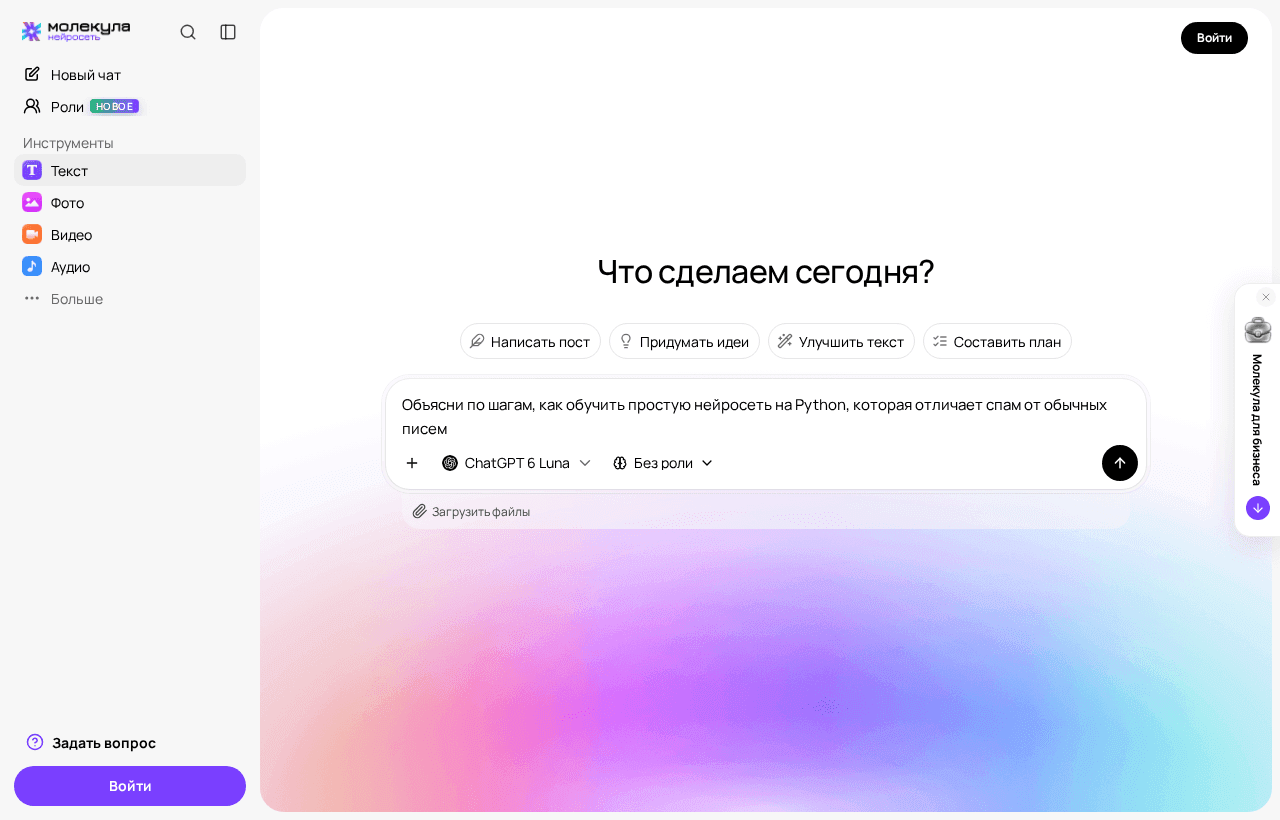
Я знаю Python на уровне функций и списков, математику на уровне школы. Есть 6 часов в неделю. Составь план на 8 недель до первого классификатора текстов: неделя, тема, практическое задание, признак того, что тема освоена.Код из раздела про первую нейросеть можно разобрать по готовому запросу про спам-классификатор: он откроется с заполненным текстом и сразу уйдёт текстовой модели.
Модель может уверенно назвать параметр библиотеки, которого не существует. Запускайте код и сверяйтесь с документацией, прежде чем принять ответ. Когда проект готов к показу, можно сгенерировать иллюстрации к проекту для слайдов или обложки репозитория.
Типичные ошибки новичков и как их не повторить
- Начинают с выбора фреймворка. Сначала задача и метрика, потом инструмент.
- Проверяют модель на обучающих данных. Без отложенной выборки высокая точность ничего не значит.
- Смотрят на общую точность при перекосе классов. Пример с 87% разобран выше.
- Дообучают, не попробовав промт. Сначала контрольные запросы к базовой модели.
- Меняют несколько вещей сразу. Ведите таблицу экспериментов: дата, что изменили, метрика.
- Не разбирают ошибки модели. Тридцать разобранных ошибок дают больше, чем новая архитектура.
Частые вопросы
Похожие статьи
 Учёба
Как работать с нейросетью с нуля самостоятельно: пошаговый план
Первый запрос, устройство хорошего промта, проверка ответов и план упражнений на две недели. Для тех, кто осваивает нейросети сам и без курсов.
 Разбор ИИ
Как создать свою нейросеть: три реальных способа
Разбираем, что реально значит создать нейросеть: обучение с нуля, дообучение готовой модели или сборка помощника на её основе.
 Гайды по моделям
Как пользоваться нейросетью: пошаговый гайд для новичка
Разбираем на практике: как сформулировать запрос, подобрать модель под текст, картинку, видео или звук и не потратить лишние токены.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды