Локальная нейросеть на ПК: требования, установка, ограничения
Что значит «локальная нейросеть» и чем она отличается от работы в браузере
Локальный запуск - это когда файл с весами модели лежит у вас на диске, а генерация считается на вашей видеокарте или процессоре. Ни один символ запроса не уходит в сеть. Интернет нужен один раз, чтобы скачать модель, дальше можно работать в самолёте.
В браузере всё наоборот: на вашей машине только текстовое поле, а считает чужой сервер с профессиональными ускорителями. Отсюда и главная развилка: локально вы получаете автономность и приватность, но упираетесь в свои 8 или 12 гигабайт видеопамяти. В облаке вы получаете модели, которые физически не влезут в домашний ПК, но платите подпиской и отдаёте текст запроса сервису. Если вам нужен результат, а не эксперимент с железом, начните с проверки на текстовых моделях без установки на компьютер и только потом решайте, стоит ли тащить всё на диск.
Дальше по порядку: сначала железо, потом модели, потом установка, потом ноутбуки и картинки, и в конце честное сравнение с браузером.
Что на самом деле упирается в железо: видеопамять, оперативка, диск
Ключевой параметр один - объём видеопамяти (VRAM). Не количество ядер, не частота, не поколение карты. Модель должна целиком поместиться в VRAM, иначе часть слоёв уходит в обычную оперативку, и скорость падает в несколько раз.
Грубый ориентир для текстовых моделей: вес файла в гигабайтах плюс 1-2 ГБ на контекст и служебные буферы. Модель на 7-8 миллиардов параметров в четырёхбитном сжатии занимает порядка 4-5 ГБ, то есть в карту на 8 ГБ влезает с запасом. Модель на 13-14 миллиардов уже просит 10-12 ГБ, на 30 и больше - от 20 ГБ.
Оперативка важна как страховка: 16 ГБ хватает для запуска небольших моделей, 32 ГБ дают возможность гонять то, что не влезло в карту, пусть и медленно. Диск лучше SSD: модели весят от 2 до 40 ГБ каждая, и загрузка весов с медленного HDD добавляет к каждому старту минуту-другую.
Проверить своё железо можно за минуту. На Windows: «Диспетчер задач», вкладка «Производительность», пункт с названием видеокарты - там указана выделенная видеопамять. На macOS память общая, отдельной VRAM нет.
Какие модели запускают локально и что такое квантование
Локально работают открытые модели с опубликованными весами: семейства Llama, Qwen, Gemma, Mistral, Phi, дистилляты DeepSeek. Закрытые флагманы так не запускаются - весов в открытом доступе просто нет, и любая инструкция «установите GPT на свой ПК» описывает либо клиент к чужому API, либо другую модель под похожим названием.
Квантование - это сжатие весов с более грубой точностью. Исходная модель хранит числа в 16 битах, квантованная - в 8, 5 или 4. Четырёхбитная версия занимает вчетверо меньше места и почти не теряет в качестве на бытовых задачах.
Практические ориентиры по форматам:
- Q4_K_M - разумный выбор по умолчанию, лучший компромисс размера и качества.
- Q5_K_M - чуть точнее, чуть больше, берите если память позволяет.
- Q8 - почти без потерь, но вдвое тяжелее четырёхбитной.
- Q2/Q3 - влезет куда угодно, но модель начинает путаться в инструкциях и цифрах. Брать только если иначе никак.
Признак, что вы взяли слишком грубое квантование: модель игнорирует формат ответа, который вы попросили, и начинает повторять фразы по кругу.
Как установить нейросеть на компьютер: пошаговый путь через Ollama и LM Studio
Это самый конкретный раздел. Два инструмента, оба бесплатные, оба на Windows, macOS и Linux.
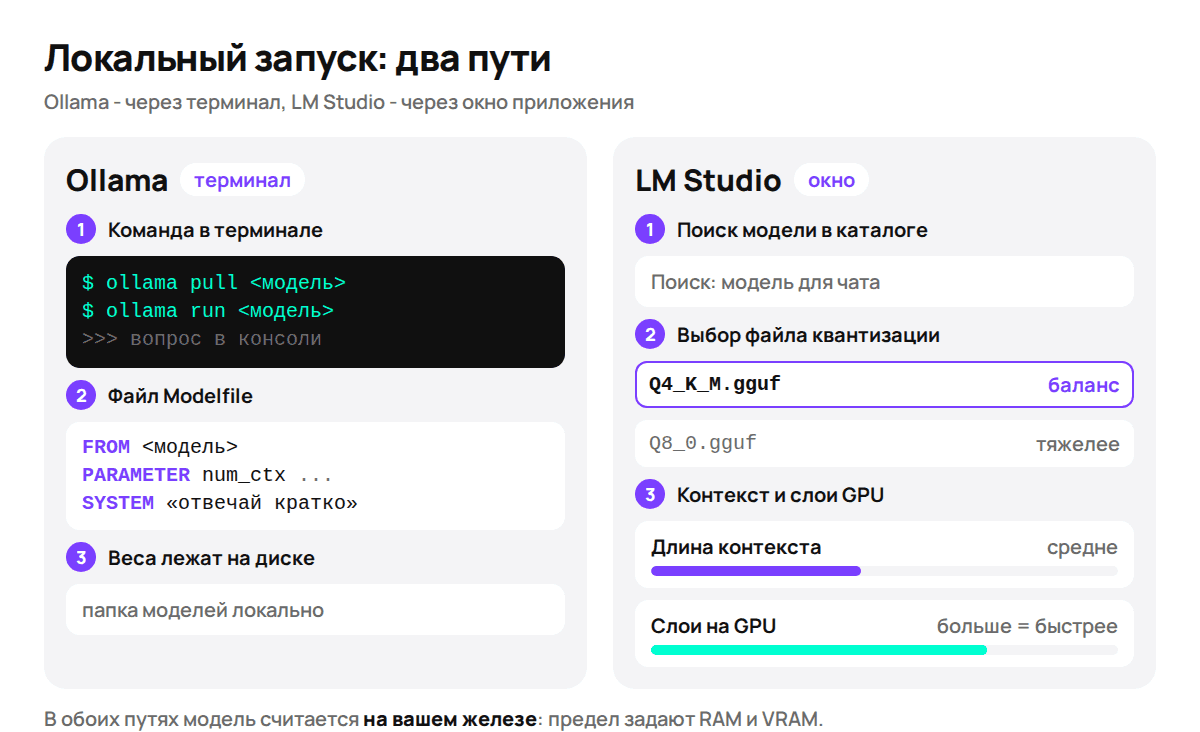
Вариант через Ollama, если вам ок терминал
- Скачайте установщик с ollama.com и поставьте, как обычную программу.
- Откройте терминал и проверьте, что всё встало: ollama --version.
- Скачайте и сразу запустите модель:
ollama run qwen2.5:7b-instruct-q4_K_MПервый запуск качает 4-5 ГБ, дальше модель стартует из локального кэша за секунды. Выход из чата - команда /bye.
- Посмотреть, что уже скачано: ollama list. Удалить лишнее: ollama rm <имя модели>.
- Если ответы медленные, уменьшите контекст. Создайте файл Modelfile:
FROM qwen2.5:7b-instruct-q4_K_M
PARAMETER num_ctx 4096
PARAMETER temperature 0.3
SYSTEM «Ты технический редактор. Отвечай по пунктам, без вступлений.»и соберите свою сборку: ollama create redactor -f Modelfile, потом ollama run redactor.
Вариант через LM Studio, если нужно окно с чатом
- Поставьте LM Studio с lmstudio.ai.
- В поиске моделей введите название семейства и размер, например qwen2.5 7b instruct.
- В списке файлов выбирайте вариант с пометкой Q4KM. Интерфейс подсказывает, влезает ли файл в вашу память.
- После загрузки откройте чат и выставьте два параметра: длину контекста (начните с 4096) и число слоёв, выгружаемых на GPU. Ставьте максимум, при котором модель грузится без ошибки нехватки памяти.
- Проверьте скорость: в окне чата видно количество токенов в секунду. Ниже 5 токенов в секунду работать неприятно, 15-20 уже похоже на нормальный диалог.
Критерий, что всё получилось: модель отвечает на вопрос «перескажи этот абзац в три пункта» именно тремя пунктами и не съезжает на английский.
Запуск на ноутбуке: чего ждать от встроенной графики и Apple Silicon
Ноутбук на Intel или AMD со встроенной графикой считает на процессоре. Модель на 7-8 миллиардов в четырёхбитном виде запустится и выдаст порядка 3-8 токенов в секунду: письмо напишет, но ждать придётся. Модели крупнее для диалога уже бесполезны.
Ноутбук с дискретной картой на 6-8 ГБ ведёт себя как настольный ПК той же категории. Главная засада - тепло: через 10-15 минут непрерывной генерации частоты снижаются, скорость просаживается.
Apple Silicon работает лучше, чем ожидают: память общая, поэтому модели доступен почти весь объём. На 16 ГБ комфортно живут модели 7-8 миллиардов, на 32 ГБ и выше - 14 и 30 миллиардов. Обе программы из предыдущего раздела на macOS используют GPU сами, ничего доустанавливать не нужно.
Чего не стоит делать: запускать генерацию от батареи. Система урезает питание, и скорость падает вдвое-втрое без всяких предупреждений.
Локальная генерация картинок: Stable Diffusion и обвязки к ней
Картинки требовательнее текста. Открытые модели семейства Stable Diffusion запускают через готовые оболочки: AUTOMATIC1111 и Forge проще на старте, ComfyUI даёт графы и точный контроль, но разбираться в нём дольше.
Порядок первого запуска:
- Поставьте оболочку по инструкции из её репозитория, включая Python и драйверы видеокарты.
- Скачайте файл модели (обычно 2-7 ГБ) и положите в папку с чекпойнтами.
- Сгенерируйте тестовый кадр 512x512 или 1024x1024 с 20-25 шагами и запишите время.
Ориентиры по времени на один кадр 1024x1024: карта на 8 ГБ - десятки секунд, карта на 12-16 ГБ - около десяти, только процессор - минуты. Отсюда вывод: если нужно перебрать двадцать вариантов композиции, локальный перебор на слабой карте съест вечер. Для перебора удобнее генерация картинок в браузере, а локальную сборку держать для того, ради чего её обычно и ставят: своих LoRA, тонкой настройки шагов и работы без отправки исходников куда-либо.
Локально или в браузере: сравнение по скорости, качеству и хлопотам
| Что сравниваем | Локально | В браузере |
|---|---|---|
| Уровень модели | открытые, до 7-30 млрд параметров на бытовом железе | флагманские, включая закрытые |
| Скорость текста | 3-20 токенов в секунду | обычно быстрее, зависит от нагрузки |
| Стартовые вложения | видеокарта, диск, вечер на настройку | регистрация |
| Плата дальше | электричество | подписка |
| Данные | не покидают компьютер | уходят на сервер сервиса |
| Работа без сети | да | нет |
| Обновления | вручную качать новые веса | появляются на стороне сервиса |
| Видео и музыка | тяжело и долго | доступно сразу |
Когда локальная модель оправдана, а когда это лишняя работа
Оправдана в четырёх случаях: вы работаете с данными, которые нельзя отправлять наружу; вам нужна работа без интернета; вы обучаете собственные LoRA и адаптеры под свой стиль; вам интересен сам процесс и вы готовы тратить на него время.
Лишняя работа, если: у вас карта меньше 6 ГБ и нет желания ждать; задачи разнородные и меняются каждый день; вам нужны длинные документы в контексте; нужны видео, музыка или озвучка. Последний пункт особенно жёсткий - открытые видеомодели существуют, но на домашней карте короткий ролик считается десятки минут, и это эксперимент, а не работа.
Стоимость ошибки честнее считать во времени. Неудачный подбор квантования - это 5-20 ГБ загрузки и полчаса на повтор. Неудачная настройка слоёв GPU - вылет по памяти и ещё двадцать минут. В браузере цена ошибки другая: один лишний запуск текстовой модели стоит от 1 кредита, картиночной - порядка 10-20 кредитов, точная цифра видна рядом с моделью.
Типичные ошибки при установке и как их разобрать
- CUDA out of memory. Модель не влезла. Уменьшите контекст до 2048-4096, возьмите квантование ниже или сократите число слоёв на GPU.
- Модель отвечает по 2-3 токена в секунду при хорошей карте. Слои считаются на процессоре. Проверьте, что в LM Studio выгрузка на GPU включена, а драйверы видеокарты свежие.
- Ответы обрываются на середине. Упёрлись в лимит генерации. Увеличьте максимальное число токенов ответа.
- Модель отвечает не на том языке. Возьмите вариант с пометкой instruct и явно задайте язык в системном сообщении.
- Скачивание встаёт на 80 процентах. Перезапустите загрузку: и Ollama, и LM Studio дописывают файл, а не начинают заново.
- Ошибка про Python и зависимости в сборках для картинок. Ставьте ту версию Python, которая указана в инструкции репозитория, в отдельное виртуальное окружение.
Общее правило отладки: меняйте один параметр за раз и записывайте токены в секунду. Иначе через час вы не поймёте, что именно помогло.
Если железа не хватает: работа с моделями через Молекулу
Когда карты нет или она слабая, остаётся браузер. Молекула - агрегатор: один интерфейс и одна подписка к текстовым, картиночным, видео и звуковым моделям, работает из России без VPN, оплата в рублях. Модели чужие, мы даём к ним доступ, а не разрабатываем их.
Как это выглядит в цифрах: внутри подписки тратятся кредиты, у каждой модели своя цена запуска. Быстрые текстовые модели вроде DeepSeek V4 Flash или Gemini 3.8 Flash стоят 1 кредит за запуск, Claude Sonnet 5 - 10 кредитов, Nano Banana 2 для картинок - 21 кредит. Квота обновляется каждый оплаченный период: в тарифе «Промо» это 1000 кредитов за 890 рублей в месяц, в бесплатном - 5 кредитов на пробу. Актуальные значения видны в интерфейсе рядом с моделью.
Разумный сценарий - смешанный. Локальная модель для черновиков и чувствительных данных, браузер для того, что требует уровня флагманов и мультимодальности.
Перед тем как качать гигабайты, можно спросить у модели, что вообще влезет в вашу карту: «У меня видеокарта на 8 ГБ и 16 ГБ оперативки. Какие открытые LLM реально запустятся локально, в каком квантовании и какой скорости ответа ждать?». Ответ стоит сверить с описанием модели на её странице загрузки: формулировки про скорость всегда приблизительные.
Частые вопросы
Похожие статьи
 Разбор ИИ
Как создать свою нейросеть: три реальных способа
Разбираем, что реально значит создать нейросеть: обучение с нуля, дообучение готовой модели или сборка помощника на её основе.
 Учёба
Нейросеть для учёбы: какую выбрать и как использовать
Разбираем, какие нейросети реально помогают студенту: конспекты, объяснение тем, поиск источников, работа с файлами и картинками.
 Разбор ИИ
Что такое нейросеть простыми словами и как она работает
Разбираем на бытовых примерах: из чего состоит нейросеть, как её обучают, почему она предсказывает слова и откуда берутся ошибки и выдумки.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды