Нейросеть для поиска информации: как искать и проверять факты
Нейросеть отвечает на вопрос текстом, а не списком сайтов. Это удобно, когда нужно собрать данные из десятка источников в одну картину, и опасно, когда нужен точный факт: часть моделей вообще не выходит в интернет и достраивает ответ по обучающим данным, включая ссылки, которых не существует.
Поэтому работа с ИИ-поиском делится на три шага: выбрать модель, которая действительно ищет в сети, сформулировать запрос так, чтобы он требовал источников, и проверить ссылки руками. Ниже разберу каждый шаг по порядку - от простых задач к сложным, где ответ приходит долго и стоит дороже. Если ваша задача ближе к расчётам и таблицам, чем к поиску формулировок, посмотрите отдельно ИИ для анализа данных: там другая логика проверки результата.
Чем поиск через нейросеть отличается от поисковой строки
Поисковик возвращает документы и оставляет вам работу по сведению их вместе. Нейросеть делает обратное: сразу выдаёт готовый текст, а первичные документы прячет за ссылками или не показывает вовсе.
Отсюда практическая разница. Поисковик почти не врёт по адресу: ссылка либо открывается, либо нет. Модель формирует правдоподобный связный текст, и правдоподобность у неё стоит выше точности. Если данных не хватает, вместо «не знаю» вы часто получаете гладкий абзац с усреднёнными цифрами.
Второе отличие - срез времени. У модели без веб-поиска есть дата окончания обучения, и всё, что случилось позже, для неё не существует. Она об этом обычно не предупреждает: просто отвечает по старым данным в настоящем времени.
Какие задачи ИИ-поиск решает хорошо, а какие портит
Хорошо получается там, где ценность в сведении и объяснении:
- собрать обзор темы по нескольким источникам и разметить, где они противоречат друг другу;
- сравнить варианты по заданным критериям, когда сравнение никто не публиковал целиком;
- объяснить незнакомую область на уровне, с которого можно задавать нормальные вопросы;
- найти формулировку или название, которое вы помните приблизительно.
Плохо получается там, где нужна одна точная величина: действующая цена, текущий курс, номер пункта в свежей редакции документа, расписание, наличие товара. Такие вещи меняются быстрее, чем обновляются индексы, и любая ошибка в одной цифре обнуляет ответ.
Отдельная категория - задачи, где важен сам исходный файл: судебное решение, приказ, техрегламент. Пересказ модели годится как навигация по теме, но цитировать в документе нужно оригинал, который вы открыли своими глазами.
Две разные вещи: модели с доступом к интернету и ответы по памяти
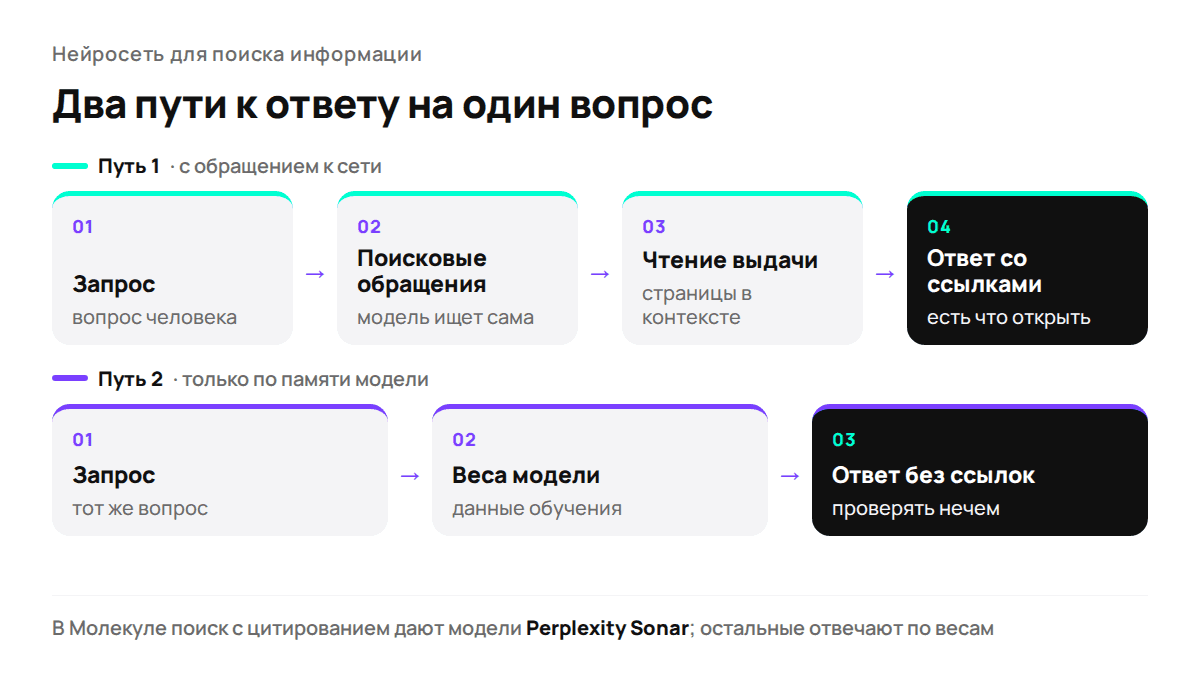
Формально это два разных механизма. Модель с веб-поиском получает запрос, делает поисковые обращения, читает выдачу и пишет ответ по найденному, прикладывая источники. Модель без поиска работает только с тем, что осело в её весах при обучении.
Отличить по ответу можно за десять секунд:
- есть кликабельные ссылки и даты публикации - скорее всего был поиск;
- есть цифры, но нет ни одного источника - ответ по памяти;
- на прямой вопрос «на какую дату актуальны данные» модель говорит про обучающий срез - поиска не было.
Проверка занимает одну строку: спросите про событие последней недели, о котором вы точно знаете сами. Модель без доступа к сети либо ответит общими словами, либо честно скажет, что не знает.
Сравнение моделей для поиска информации
Цены ниже - стоимость запуска в кредитах в Молекуле на момент написания статьи; актуальную вы видите рядом с моделью перед отправкой запроса.
| Модель | Что заявлено | Запуск | Когда брать |
|---|---|---|---|
| Perplexity Sonar | веб-поиск, принимает до 5 картинок | 2 кредита | быстрые фактические вопросы, первый заход |
| Perplexity Sonar PRO | поиск в реальном времени, до 5 картинок | 15 кредитов | тема, где нужно много источников за один ответ |
| Perplexity Sonar Deep Research | глубокий веб-ресёрч с цитированием источников | 8 кредитов | обзор темы, разбор противоречий |
| Grok 4.6 | работа с актуальными данными, картинки и файлы | 7 кредитов | свежие обсуждения и новости |
| Claude Sonnet 5 | до 20 картинок, файлы | 10 кредитов | разбор своих документов |
| Gemini 3.1 Pro | до 16 картинок, видео, звук, файлы | 12 кредитов | смешанные материалы: скриншоты, записи |
| ChatGPT-5.5 | картинки, видео, звук, файлы | 28 кредитов | длинный разбор с вложениями |
Модели из нижней половины таблицы сами по интернету не ходят: они сильны на ваших материалах. Смешивать роли не стоит - за фактами идите к первым, за разбором файлов ко вторым.
Как сформулировать запрос, чтобы получить факты, а не общий пересказ
Запрос на поиск состоит из четырёх строк: задача, обязательные источники, формат ответа, ограничения. Без третьей и четвёртой строк модель выдаёт эссе.
Задача: собери данные по <тема> за <период>.
Источники: только материалы, которые ты открыл сейчас;
на каждый факт - ссылка и дата публикации.
Формат: таблица «факт | цифра | источник | дата».
Ниже отдельным списком - расхождения между источниками.
Ограничения: если данных нет, пиши «не найдено»,
не оценивай и не усредняй. Не используй свою память
без пометки «по обучающим данным».Заполненный пример под тему рынка: «Задача: собери данные по продажам электромобилей в России за последний год. Источники: только то, что открыто сейчас, на каждый факт ссылка и дата. Формат: таблица факт, цифра, источник, дата. Ниже список расхождений. Ограничения: нет данных - пиши «не найдено»».
Дальше два уточняющих хода, не больше:
- «По строкам 2 и 5 приведи цитату из источника дословно» - так видно, есть ли за цифрой текст.
- «Что из ответа ты не смог подтвердить ссылкой» - модель сама выносит слабые места.
Результат считаю годным, если каждая цифра в таблице имеет ссылку, ссылки открываются, и в найденном тексте цифра совпадает с ответом. Если из семи строк подтвердились две, дело не в запросе, а в том, что данных в открытых источниках нет: переформулируйте задачу, а не гоняйте модель по кругу.
Проверить каркас можно сразу: откройте запрос на обзор рынка с требованием ссылок и дат и сравните ответ с тем, что даёт та же модель без строки про источники.
Как проверять источники и ловить выдуманные ссылки
Выдуманная ссылка выглядит нормально: правильный домен, правдоподобный путь, иногда даже правильная рубрика. Модель собрала её по шаблону, потому что так выглядят адреса на этом сайте.
Порядок проверки, который занимает пару минут:
- Открыть каждую ссылку. Ошибка 404 или главная страница вместо материала - факт не подтверждён.
- Найти на открытой странице ту самую цифру поиском по тексту. Нет совпадения - значит цифра пришла из другого места или из ниоткуда.
- Посмотреть дату публикации и дату данных внутри. Статья 2024 года про «прошлый год» говорит не о том годе, что вы имели в виду.
- Дойти до первоисточника. Если ссылка ведёт на новость, которая ссылается на отчёт, брать надо отчёт.
- Сверить два независимых источника на ключевых цифрах. Расходятся - в тексте пишите диапазон, а не среднее.
Чего делать не стоит: просить модель «перепроверить свой ответ». Она перепишет его теми же словами и подтвердит сама себя. Проверка живёт вне диалога.
Поиск по своим материалам: файлы, скриншоты, записи
Часто искать надо не в интернете, а в собственном архиве: договор на сорок страниц, папка скриншотов, запись созвона. Здесь берут модели с приёмом вложений, и веб-поиск не нужен.
Как это выглядит по шагам:
- Приложить файл и задать вопрос по содержимому: «найди в договоре все сроки и ответственность за их нарушение, укажи номера пунктов».
- Потребовать цитаты: без них модель перескажет смысл приблизительно.
- Проверить пункты в самом файле. Номер пункта проверяется за пять секунд, и это ловит большинство ошибок.
По вложениям есть лимиты: Claude Sonnet 5 принимает до 20 картинок за запрос, Gemini 3.1 Pro до 16, модели линейки ChatGPT до 10. Длинную запись созвона логичнее сначала перевести в текст транскрипцией, а уже потом искать по стенограмме.
Отдельные задачи такого поиска вынесены на сайте в отдельные страницы: поиск места по фото и поиск музыки через нейросеть.
Глубокий ресёрч: когда имеет смысл ждать долгий ответ
Режим глубокого ресёрча отличается от обычного поиска количеством обращений: модель делает много запросов, читает больше страниц и собирает ответ с цитированием. Ответ приходит не за секунды, а за минуты.
Брать его стоит, когда тема требует сведения многих источников: обзор рынка, подборка исследований по спорному вопросу, сравнение регулирования в разных странах. На вопрос «какой сейчас курс» это лишняя трата: быстрый поиск ответит точнее.
Практическое правило по цене ошибки. Перплексити Sonar стоит 2 кредита за запуск, Deep Research - 8, Sonar PRO - 15. Первый заход делайте дешёвой моделью: она покажет, есть ли вообще данные в открытых источниках. Если данных нет, дорогой запуск их не найдёт, и три неудачных подхода к Sonar PRO съедят 45 кредитов без результата.
Как это устроено в Молекуле: выбор модели и расход кредитов
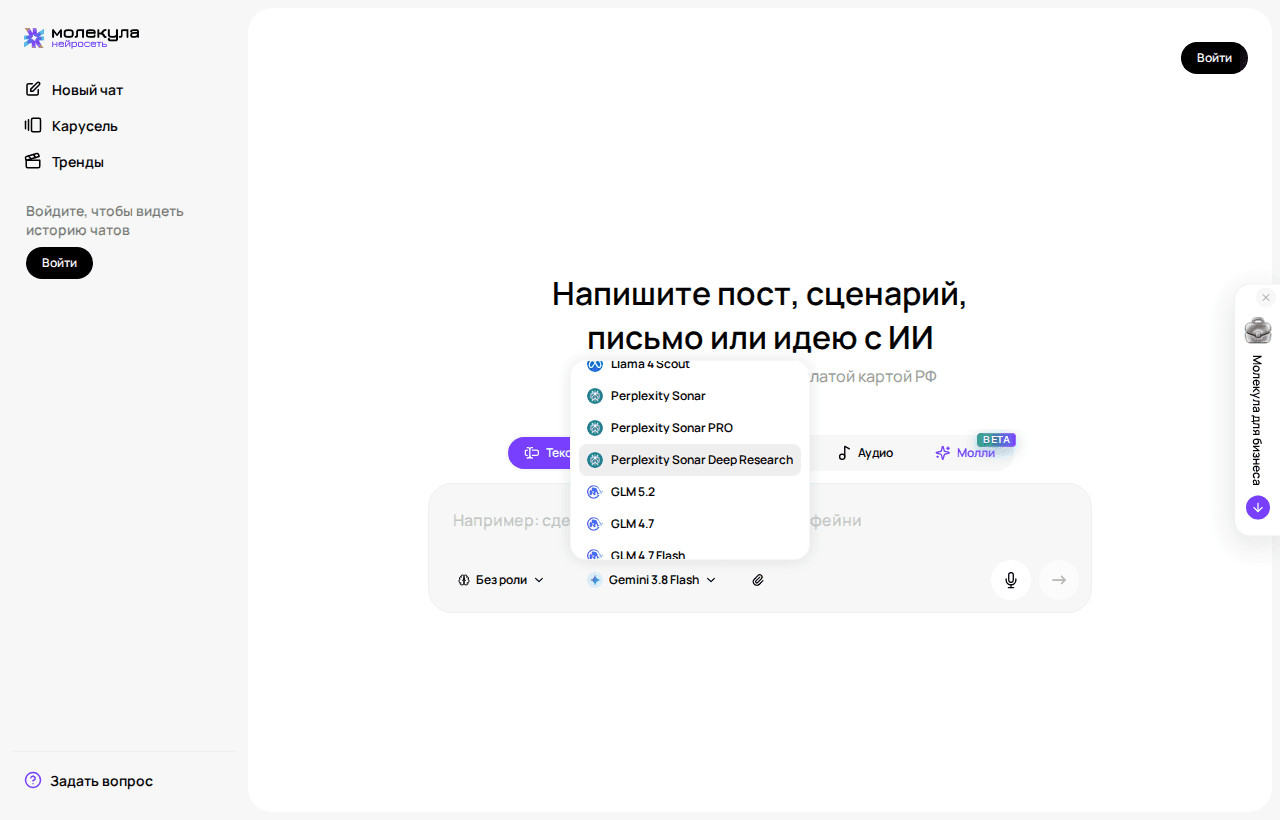
Схема простая: выбираете модель, отправляете запрос, с квоты списываются кредиты по стоимости запуска этой модели. Стоимость видна рядом с моделью до отправки, так что дорогой запуск нельзя сделать случайно.
Бесплатный тариф даёт 5 кредитов. Этого хватит на пару запусков Perplexity Sonar по 2 кредита - достаточно, чтобы проверить на своей задаче, возвращает ли модель рабочие ссылки. Оплата российской картой в рублях, VPN не нужен.
Важная оговорка: доступ идёт к чужим моделям через сторонний интерфейс, и обвязка может отличаться от официального приложения вендора. Поведение веб-поиска стоит один раз проверить на задаче, где вы знаете правильный ответ. Если вам нужен не поиск, а текст на основе найденного, это уже другая задача - генерация текста.
Частые ошибки при поиске информации через ИИ
- Спрашивать факт у модели без веб-поиска. Ответ будет уверенным и устаревшим.
- Копировать цифру из ответа в документ, не открыв источник. Это основная причина, по которой потом приходится переделывать работу целиком.
- Задавать вопрос одной строкой: «что с рынком электромобилей». Без формата и требования источников получите пересказ общих мест.
- Просить «самые свежие данные» без указания периода. Формулируйте границы: «за последние 12 месяцев», «после января».
- Верить в единственный источник. Если цифру повторяют пять новостных сайтов со ссылкой друг на друга, это один источник, а не пять.
- Спорить с моделью вместо смены модели. Два уточнения не помогли - меняйте инструмент или признайте, что данных нет.
- Гнать дорогой ресёрч по кругу. Каждая попытка стоит кредиты, а причина обычно в задаче, а не в модели.
Частые вопросы
Похожие статьи
 Разбор ИИ
Как создать свою нейросеть: три реальных способа
Разбираем, что реально значит создать нейросеть: обучение с нуля, дообучение готовой модели или сборка помощника на её основе.
 Учёба
Нейросеть для учёбы: какую выбрать и как использовать
Разбираем, какие нейросети реально помогают студенту: конспекты, объяснение тем, поиск источников, работа с файлами и картинками.
 Разбор ИИ
Что такое нейросеть простыми словами и как она работает
Разбираем на бытовых примерах: из чего состоит нейросеть, как её обучают, почему она предсказывает слова и откуда берутся ошибки и выдумки.
Корпоративный доступ к ИИ-моделям
Счёт для юрлица, централизованная оплата, приоритетная поддержка
- Доступ к моделям ChatGPT, Gemini, Grok, Claude, DeepSeek
- Библиотека промтов и общий доступ внутри команды